
Particle-1: agentic-модель, которая тратит на 45% меньше токенов — обзор и доступ через RouterAI
Particle AI 28 октября 2026 года выпустила первую модель — Particle-1. Это пост-обучение DeepSeek V4.1 Flash с одной целью: решать задачи по программной инженерии, тратя меньше токенов на рассуждения и вызовы инструментов. По данным компании, в среднем модель использует примерно на 45% меньше токенов, чем база, а точность остаётся в пределах доверительного интервала. В каталоге RouterAI она доступна как particle-ai/particle-1: контекст 1M токенов, вход от 5,34 ₽ за миллион, доступ из России без VPN, оплата в рублях. Разбираем, что заявлено, как это проверить на своих задачах и с кем модель стоит в одном ряду.
Что такое Particle-1
Particle-1 — модель от Particle AI, обученная с подкреплением (RL) поверх DeepSeek V4.1 Flash. Награда в обучении поощряет успешное решение задачи при меньшем числе токенов на рассуждения и вызовы инструментов. По описанию в блоге, дообучали LoRA-адаптер ранга 64, который покрывает экспертов во всех слоях; это около 1,25% параметров модели. Среды для обучения — задачи по кодингу и data engineering.
Первый релиз сфокусирован на software engineering, другие области Particle обещает «в будущих релизах». Модель доступна через Particle API, а также через Vercel AI Gateway, где она подаётся как инструмент для отладки, планирования правок и разбора многошаговых инженерных задач.
Где Particle-1 экономит токены, в блоге описано четырьмя паттернами:
- меньше рассуждений на те же действия;
- остановка после выполнения задачи, без повторных проверок и длинного финального резюме;
- меньше раундов «попытка — исправление»;
- более целенаправленное исследование кода и проверка результата.
Около 90% экономии на Terminal-Bench 2.1, ReactBench и ADE Bench приходится на токены рассуждений; на DeepSWE 1.1 примерно 30% добавляет текст вызовов инструментов.
Заявленные метрики
Все цифры в этом разделе — измерения самой Particle AI из блога компании. Независимых прогонов на момент статьи мало, поэтому воспринимайте их как заявку, а не как факт.
Particle сравнивала модель на четырёх бенчмарках: DeepSWE 1.1, Terminal-Bench 2.1, ReactBench и ADE Bench (аналитика и data engineering на dbt). Усреднённые результаты:
| Модель | Стоимость за задачу | Выходных токенов на задачу | Доля решённых задач |
|---|---|---|---|
| Particle-1 | $0,2211 | 59 580 | 72,57% |
| DeepSeek V4.1 Flash | $0,3368 (в 1,5 раза дороже) | 83 246 (в 1,4 раза больше) | 71,15% |
| GLM 5.3 Flash | $0,6523 (в 3,0 раза дороже) | 98 155 (в 1,6 раза больше) | 66,82% |
По отдельным бенчмаркам Particle-1 тратит на 28,4–52,2% меньше выходных токенов и на 34,4–51,6% дешевле за задачу, чем DeepSeek V4.1 Flash. Pass@1 при этом, по словам авторов, укладывается в доверительные интервалы базовой модели: разница в 1,4 процентного пункта в таблице — не доказанное преимущество.
Что важно учесть при чтении:
- стоимость за задачу в посте посчитана по ценам Particle ($0,30 за 1M входных, $1,20 за 1M выходных токенов для Particle-1 и DeepSeek; $0,15 и $0,50 для GLM) при фиксированной доле попаданий в кэш 95%. В каталоге RouterAI цены свои (ниже), так что доллары из поста переносить на RouterAI нельзя;
- DeepSWE 1.1 запускали через mini-swe-agent, остальные три бенчмарка — через Terminus 2; везде максимальное рассуждение, лимит 512 тысяч токенов, температура 1;
- вне обучающих доменов точность осталась близкой к базе: GPQA Diamond 90,40% (у базы 90,91%), Tau Airlines 86,00% (88,00%), MMLU 86,08% (85,98%), BabyVision с инструментами 89,18% (89,60%).
Характеристики
| Параметр | Значение |
|---|---|
| id в RouterAI | particle-ai/particle-1 |
| Контекст | 1 048 576 токенов |
| Максимум на выходе | до 131 072 токенов (по документации Particle; без явного лимита — 32 000) |
| Вход | текст и изображения (text+image->text) |
| Рассуждения | включены по умолчанию, уровень high; настраиваются через reasoning_effort
|
| Вызов функций |
tools и tool_choice в формате OpenAI |
| Структурированный вывод |
json_object принимается; строгое следование JSON-схеме Particle не гарантирует |
В каталоге RouterAI у модели заявлены параметры reasoning, reasoning_effort, tools, tool_choice, response_format. Тестовый запрос с функцией get_invoice вернул tool_calls с аргументом {"id": "A-1024"}.
Цены в RouterAI
Цены из каталога RouterAI на 9 ноября 2026 года, рубли за 1M токенов: вход 5,34 ₽, выход 53,39 ₽, чтение из кэша 0,32 ₽. Актуальные значения смотрите в карточке модели.
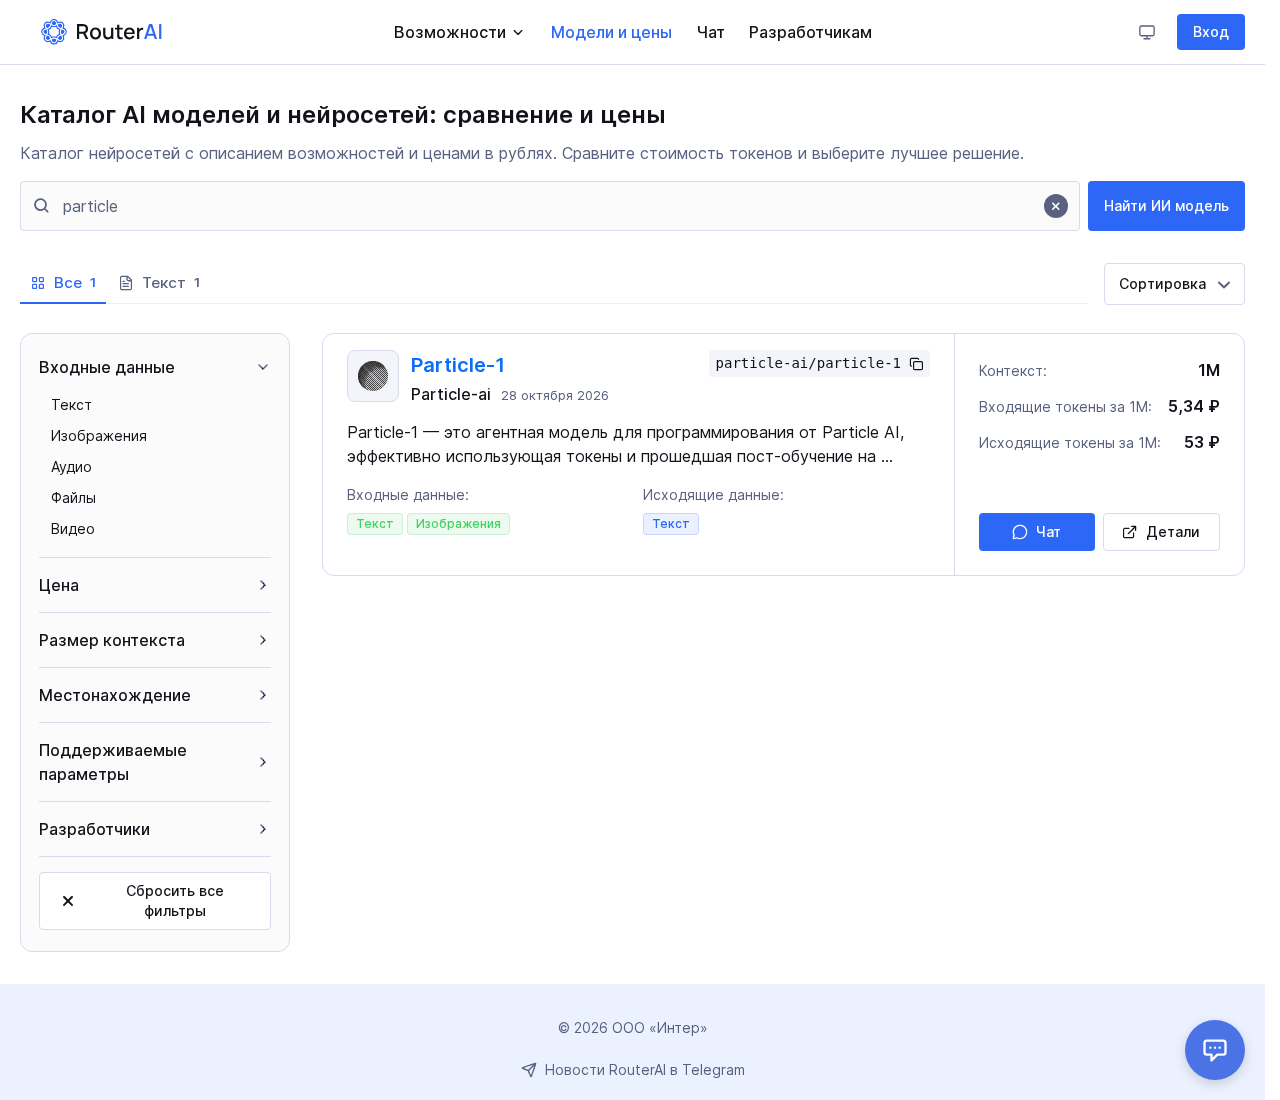
В посте Particle у Particle-1 и DeepSeek V4.1 Flash одинаковые цены, в каталоге RouterAI они разные: у DeepSeek V4.1 Flash вход 2,58 ₽, выход 46,98 ₽. Поэтому выигрыш придётся считать самим. Простая прикидка на заявленных Particle средних значениях: 59 580 выходных токенов на задачу у Particle-1 против 83 246 у DeepSeek. По ценам каталога выходная часть выходит примерно в 3,2 ₽ против 3,9 ₽ за задачу. Входной поток у Particle-1 при этом вдвое дороже, так что итог зависит от доли входа и попаданий в кэш на вашей нагрузке. Длинные агентные сессии обычно держат большой повторяющийся префикс, и там помогает дешёвое чтение из кэша (0,32 ₽).
Подробнее о том, из чего складывается цена сессии, — в статье «Сколько стоит агентная сессия».
Сравнение с соседями
Цены из каталога RouterAI на 9 ноября 2026 года, ₽ за 1M токенов.
| Модель | Вход | Выход | Кэш: чтение | Контекст | Принимает | Когда брать |
|---|---|---|---|---|---|---|
particle-ai/particle-1 |
5,34 | 53,39 | 0,32 | 1M | текст, изображения | длинные агентные сессии, где важны токены рассуждений |
deepseek/deepseek-v4.1-flash |
2,58 | 46,98 | 0,47 | 1M | текст, изображения | база Particle-1: дешевле на входе и выходе, но без оптимизации токенов |
z-ai/glm-5.3-flash |
3,93 | 9,75 | 3,52 | 1M | текст, изображения, видео | выход в несколько раз дешевле, когда модель много пишет |
moonshotai/kimi-k3.1-pro |
32,35 | 869,51 | 21,36 | 1M | текст, изображения, видео | крупная модель для сложных задач, выход дорогой |
anthropic/claude-sonnet-5.5 |
213,56 | 1067,80 | 10,68 | 1M | текст, изображения, файлы | критичный код и спорные места, где нужна основная модель |
Что видно из таблицы:
- по цене Particle-1 в одном классе с DeepSeek V4.1 Flash и GLM 5.3 Flash, и в десятки раз дешевле Claude Sonnet 5.5: по входу в 40 раз, по выходу — в 20;
- у GLM 5.3 Flash самый дешёвый выход: 9,75 ₽ против 53,39 ₽ у Particle-1. Для задач с длинными ответами сравнивайте стоимость сессии, а не цену за токен;
- по качеству на одной методике независимых сравнений Particle-1 с Kimi и Sonnet нет. Цифры Particle сравнивают её только с DeepSeek V4.1 Flash и GLM 5.3 Flash.
Другие дешёвые агентные модели — в обзорах MiniMax M3.1 Flash и Kimi K3.1 Pro.
Как вызвать через API
RouterAI даёт OpenAI-совместимый API: Base URL https://routerai.ru/api/v1, ключ создаётся в личном кабинете.
curl https://routerai.ru/api/v1/chat/completions \
  -H "Authorization: Bearer sk-xxxxxxxxxxxxxxxx" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "particle-ai/particle-1",
    "reasoning_effort": "none",
    "messages": [
      {"role": "user", "content": "Объясни, что делает git rebase --onto"}
    ]
  }'
reasoning_effort: "none" отключает рассуждения: на запросе «Скажи ок» с этим значением модель потратила 0 токенов на рассуждения и 2 токена на ответ. Для кода и агентов рассуждения лучше оставить включёнными (по умолчанию high). Подробнее про уровни — в глоссарии про reasoning-модели.
Тот же вызов через OpenAI SDK для Python:
from openai import OpenAI

client = OpenAI(
    base_url="https://routerai.ru/api/v1",
    api_key="sk-xxxxxxxxxxxxxxxx",
)

resp = client.chat.completions.create(
    model="particle-ai/particle-1",
    messages=[{
        "role": "user",
        "content": "Добавь в invoices.js функцию overdueTotal(invoices) "
                   "и тест к ней.",
    }],
    max_tokens=8000,
)
u = resp.usage
print(resp.choices[0].message.content)
print(u.prompt_tokens, u.completion_tokens,
      u.completion_tokens_details.reasoning_tokens)
Поле usage.completion_tokens_details.reasoning_tokens показывает, сколько из выходных токенов ушло на рассуждения: именно эту величину Particle-1 должна сокращать. На демо-проекте с небольшим модулем счетов такой запуск выглядит так (скрипт читает ключ из переменной окружения, последняя строка — расход):
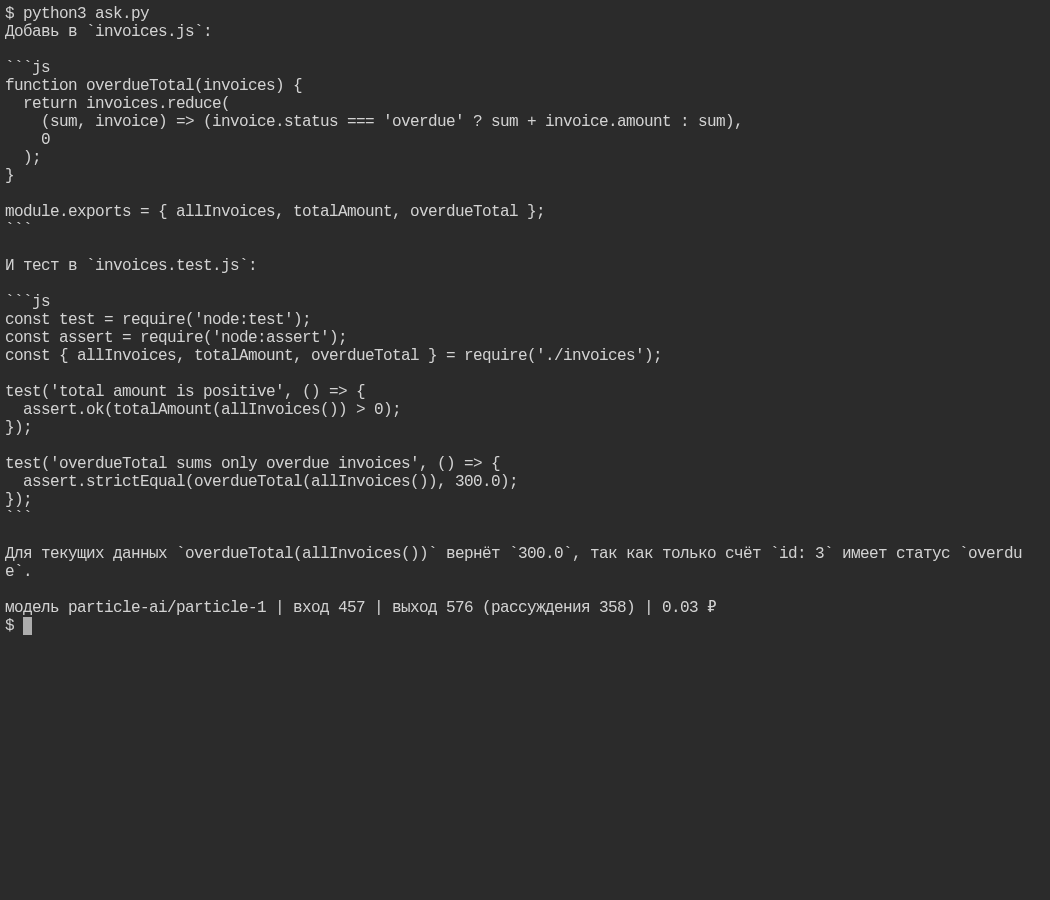
Это один запрос, а не замер: число токенов от запуска к запуску меняется. Чтобы оценить экономию на своей работе, прогоните одну и ту же задачу на particle-ai/particle-1 и deepseek/deepseek-v4.1-flash и сравните reasoning_tokens и стоимость по полю usage.
Подключение к агентам
Модель принимает вызовы функций в формате OpenAI, поэтому её можно выбрать в любом агенте, который работает с OpenAI-совместимым провайдером. Параметры одни и те же:
| Поле | Значение |
|---|---|
| Base URL | https://routerai.ru/api/v1 |
| API Key | ключ RouterAI (sk-xxxxxxxxxxxxxxxx) |
| Model | particle-ai/particle-1 |
Пошаговые инструкции по конкретным инструментам: Codex, Aider, OpenCode, Cline в VS Code. Везде меняется только id модели.
Для клиентов на Anthropic Messages API (например, Claude Code) используется адрес https://routerai.ru/api: запрос к Particle-1 в этом формате проходит и возвращает ответ с блоком рассуждений. Подключение самого агента описано в статье «Вайб-кодинг в Claude Code».
Логичное место для недорогой модели — массовые задачи, где агент делает много шагов: например, ревью кода в CI. В Open Code Review модель задаётся одной командой в конфиге:
ocr config set custom_providers.routerai.url https://routerai.ru/api/v1
ocr config set custom_providers.routerai.protocol openai
ocr config set custom_providers.routerai.model particle-ai/particle-1
ocr config set custom_providers.routerai.api_key "$ROUTERAI_API_KEY"
ocr config set provider routerai
Ограничения
- Только API. В материалах Particle о публикации весов не сказано, поэтому самостоятельно развернуть её, по имеющимся данным, нельзя: работать приходится через API Particle, шлюзы вроде RouterAI или Vercel AI Gateway.
- Фокус на разработке. Обучение шло на задачах по кодингу и data engineering. Что с экономией токенов и точностью в творческих, аналитических и других не кодовых задачах, неизвестно: Particle показывает лишь один пример по юридическому ревью договора, где модель использовала на 24,6% меньше выходных токенов.
- Метрики вендора. Все цифры из блога — внутренние, независимых прогонов пока мало. Экономия токенов зависит от задачи: диапазон в посте — от 28,4% до 52,2%.
-
Строгие схемы. JSON Schema модель не гарантирует: для структурированного вывода принимается
json_object. - Цена зависит от доли входа. Вход у Particle-1 дороже, чем у DeepSeek V4.1 Flash, так что на коротких задачах с большим промптом выигрыша может не быть.
Что дальше
Particle-1 уже в каталоге RouterAI: создайте ключ, пополните баланс картой РФ в рублях и сравните модель со своей текущей на одной и той же задаче. Решение лучше принимать по двум числам из usage: сколько токенов ушло на рассуждения и во сколько это обошлось.
- Каталог моделей — цены и параметры актуальных моделей;
- Сколько стоит агентная сессия — как считать стоимость задачи для дешёвых и дорогих моделей;
- MiniMax M3.1 Flash и Claude Haiku 5.5 — другие недорогие модели для агентов;
- Документация Particle API — описание модели и параметров рассуждений.