Kimi K3.1 Pro: обзор модели Moonshot и доступ из России через RouterAI
23 октября 2026 года Moonshot AI выпустила Kimi K3.1 Pro — первую модель новой серии K3.1. Это не новая архитектура, а K3, дообученная заметно дольше: по формулировке из технического блога Moonshot, «post-trained version of Kimi K3, with substantially larger post-training compute». Отдача оказалась непропорционально большой: в агентных задачах прирост измеряется сотнями баллов, а вендорский прайс за токен в долларах ниже, чем у K3.
Разбираем, что изменилось, какие цифры приводит вендор и какие — независимые замеры, сколько модель стоит в рублях и когда её брать вместо флагманов.
Что случилось
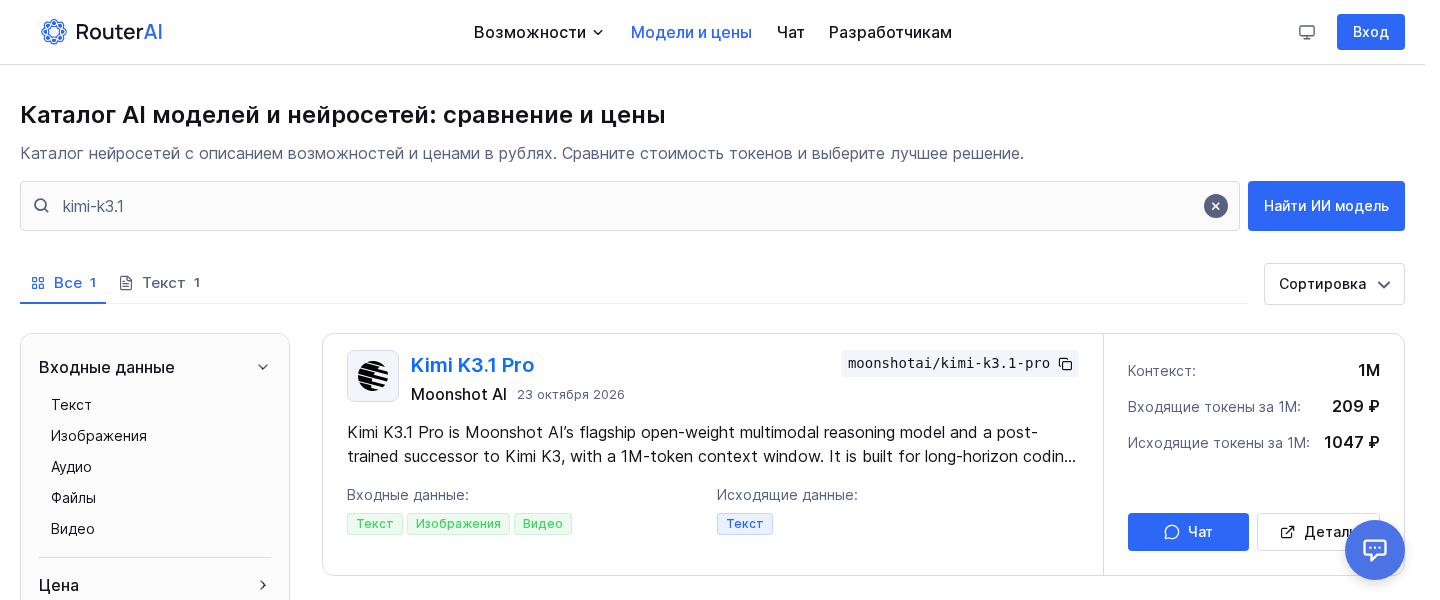
Kimi K3.1 Pro вышла 23 октября 2026 года и доступна на kimi.ai, в Kimi Work, Kimi Code и через Kimi API. В каталоге RouterAI модель появилась в тот же день под id moonshotai/kimi-k3.1-pro.
Оговорка про «открытость». Moonshot называет K3.1 Pro «3T-class open-weight model», но веса не опубликованы: вендор обещает выложить их до 4 ноября 2026 года. В архиве релизов The Model Gap это зафиксировано отдельно: «Weights are promised by 2026-11-04 and are not public». Сейчас это модель с API-доступом, а не открытая модель в строгом смысле.
По карточке Artificial Analysis: 2,8 трлн параметров всего, 104 млрд активных, контекст 1 млн токенов, вход — текст и изображения.
Что нового относительно K3
Та же база, другой режим дообучения: совместное обучение с подкреплением сразу по сотням доменов — от кодинга и 3D до финансовых задач. Moonshot отдельно пишет, что переписал инфраструктуру (RL-фреймворк, инференс на длинном контексте, планировщик rollout'ов), чтобы каждый шаг обучения давал предсказуемую прибавку.
Что видно в цифрах:
- Агентные задачи выросли сильнее всего. GDPval-AA — 1 846 Elo, плюс 312 баллов к Kimi K3 и третье место.
- Фактических ошибок стало меньше. На внутреннем Kimi Hallu Bench Hard доля утверждений с галлюцинациями упала с 23,4% до 8,3%. По независимой оценке AA-Omniscience галлюцинации снизились с 53% до 44%, точность выросла с 48% до 51%.
- Cyber-возможности намеренно урезаны. Moonshot убрала кибербезопасностные данные из mid-training и RL-сред. На внутреннем xdev-bench-hard (поиск и эксплуатация уязвимостей) чекпоинт без этих ограничений решал 90,5% задач при pass@3, финальная модель — 81,0%.
Подробный разбор предыдущей модели — в статье Kimi K3; архитектуру KDA и Attention Residuals там уже описали, они те же.
Бенчмарки: что измерял вендор и что независимые
Цифры ниже — чужие замеры, мы их не воспроизводили. Условия Moonshot указывает в сносках: reasoning effort max, temperature 1.0, top-p 0.95, кодинг-задачи — в harness Claude Code.
| Бенчмарк | Kimi K3.1 Pro | Для сравнения | Источник и дата |
|---|---|---|---|
| Terminal-Bench 4.0 | 65,7% | GPT-6 Astra — 58,2%, Claude Opus 5.5 — 66,4% | Moonshot, 23.10.2026 |
| Terminal-Bench 4.0, независимо | 67% | Claude Sonnet 5.5 — 64% | Artificial Analysis, 23.10.2026 |
| Humanity's Last Exam | 52% | Kimi K3 — 47% | Artificial Analysis, 23.10.2026 |
| GDPval-AA | 1 846 Elo | Kimi K3 — 1 534; Claude Opus 5.5 — 1 866 | Artificial Analysis, 23.10.2026 |
| AutomationBench-AA | 73% | Kimi K3 — 58% | Artificial Analysis, 23.10.2026 |
| Kimi Code Bench 3.0 Long-horizon | 61,2% | Kimi K3 — 55,95% | Moonshot, внутренний |
| BenchCAD, 3D с инструментами | 92,7% | Opus 5.5 — 96,2%, GPT-6 Astra — 95,9% | Moonshot, 23.10.2026 |
| OfficeQA Pro v2 | 64,4 | — | Moonshot, 23.10.2026 |
Два числа требуют пояснения. Первое: Moonshot даёт на Terminal-Bench 65,7% и ставит модель чуть ниже Opus 5.5, а Artificial Analysis на том же бенчмарке получила 67% и назвала это лучшим результатом среди протестированных моделей. Расхождение — в harness и настройках прогона, и это ровно тот случай, когда «модель X обошла Y» зависит от того, чей замер вы читаете.
Второе: сравнение с K3 по HLE и Terminal-Bench у Artificial Analysis нельзя считать чистым приростом качества — для K3 в тот же день была строка с явно указанным max, а для K3.1 Pro — без суффикса усилия. The Model Gap пишет об этом прямо: «the gaps are not matched-effort».
Контекст 1M токенов
Миллион токенов — это примерно 750 тысяч слов или несколько сотен тысяч строк кода; в каталоге RouterAI у модели context_length 1 048 576. Такой объём нужен в трёх случаях:
- Репозиторий целиком. Монорепозиторий среднего размера влезает в один запрос — без ручной сборки релевантных файлов.
- Длинные логи и трейсы. Вывод тестов, набор трейсов, лог многочасового инцидента — без нарезки и потери связей между событиями.
- Пакеты документов. Отчётность за несколько периодов, договоры, спецификации. OfficeQA Pro v2 у Moonshot — как раз про анализ фискальных данных по реальным PDF-корпусам.
Ограничение — цена. Вход стоит 209,40 ₽ за 1 млн токенов: запрос на 800 тыс. токенов обойдётся примерно в 168 ₽ только за чтение контекста, без выхода.
Агентные сценарии
Именно здесь прирост заметнее всего: GDPval-AA плюс 312 Elo, AutomationBench-AA — с 58% до 73%. Второй бенчмарк про агентные рабочие процессы в SaaS-интерфейсах, то есть клики, формы и последовательности действий, а не генерацию текста.
Вызов инструментов в каталоге заявлен набором tools, tool_choice, structured_outputs. Отдельного parallel_tool_calls карточка не перечисляет, но на практике модель возвращает несколько вызовов в одном ответе: в нашем запросе к moonshotai/kimi-k3.1-pro с двумя функциями finish_reason пришёл tool_calls, оба вызова корректные.
Для агентов важна ещё одна деталь: reasoning_effort работает, в отличие от первых недель Kimi K3, где доступен был только максимум. На рутинных шагах цепочки усилие можно опустить до low и сэкономить токены рассуждений — они тарифицируются как выходные.
Сколько стоит
Официальные цены Moonshot: $2 за 1 млн входных токенов, $10 за выходные и $0,20 при попадании в кэш — на треть ниже, чем у Kimi K3 по всем трём ставкам. Вариант Highspeed стоит $4/$20; отдельной записью в каталоге RouterAI он не представлен.
В рублях на 26 октября 2026 года в каталоге RouterAI:
| Модель | Вход, ₽ / 1M | Выход, ₽ / 1M | Контекст |
|---|---|---|---|
moonshotai/kimi-k3.1-pro |
209,40 | 1 047,00 | 1,05M |
moonshotai/kimi-k3 |
125,64 | 575,85 | 1,05M |
В рублях K3.1 Pro дороже K3 примерно на 67% по входу и на 82% по выходу — хотя прайс вендора в долларах ниже на треть. Цифры не сходятся напрямую, и это нормально: рублёвые цены динамические, зависят от курса и от фактического провайдера запроса. Ориентируйтесь на карточку модели, а не на пересчёт долларов по курсу.
Экономику задачи это не ломает. Artificial Analysis измеряет стоимость выполнения задания Intelligence Index в $1,98 — примерно столько же, сколько у Kimi K3: K3.1 Pro тратит 55 тыс. выходных токенов на задачу против 48 тыс. и решает её лучше. Цена за токен и цена за результат — разные вещи.
Сравнение с альтернативами в каталоге
| Модель | Вход, ₽ / 1M | Выход, ₽ / 1M | Контекст | Назначение |
|---|---|---|---|---|
moonshotai/kimi-k3.1-pro |
209,40 | 1 047,00 | 1,05M | Агентный кодинг на длинном горизонте, длинный контекст, текст и изображения |
anthropic/claude-sonnet-5.5 |
209,40 | 1 047,00 | 1M | Повседневная разработка, документы и таблицы |
openai/gpt-5.6-sol |
418,80 | 2 093,99 | 1,05M | Сложный кодинг, командная строка, многошаговые задачи |
z-ai/glm-5.3 |
7,32 | 146,58 | 1,05M | Дешёвый агентный кодинг, где критична цена входа |
deepseek/deepseek-v4-pro |
111,72 | 223,44 | 1,05M | Рассуждения и код с очень дешёвым выходом |
anthropic/claude-opus-5.5 |
418,80 | 2 093,99 | 1M | Многошаговые правки в крупных кодовых базах, ревью, финансы |
- K3.1 Pro стоит ровно столько же, сколько Claude Sonnet 5.5 — 209,40 ₽ на входе и 1 047,00 ₽ на выходе. Пара становится прямыми конкурентами: выбор идёт не по цене, а по поведению на вашей задаче. На Terminal-Bench по замеру Artificial Analysis K3.1 Pro впереди — 67% против 64%.
- GPT-5.6 Sol и Opus 5.5 вдвое дороже — 418,80 ₽ на входе, 2 093,99 ₽ на выходе. По бенчмаркам K3.1 Pro от Opus 5.5 почти не отстаёт: 65,7% против 66,4% и 1 846 против 1 866 Elo. Но это не значит, что модели взаимозаменяемы.
- GLM-5.3 почти в 29 раз дешевле на входе и в 7 раз на выходе. Если нагрузка — много коротких запросов с небольшим ответом, экономия будет заметной.
- DeepSeek V4 Pro дешевле на выходе почти в 4,7 раза — для генерации больших объёмов кода это важнее, чем разница во входе.
Сравнение по цене и контексту — единственное, что здесь проверяемо объективно: публичных независимых замеров, где все шесть моделей прогонялись бы по одной методике на одной инфраструктуре, на момент статьи нет.
Как подключить
RouterAI отдаёт K3.1 Pro по OpenAI-совместимому API: Base URL https://routerai.ru/api/v1, ключ — из настроек аккаунта, модель указывается id из каталога. Оплата в рублях, работает из России без VPN.
curl https://routerai.ru/api/v1/chat/completions \
  -H "Authorization: Bearer sk-xxxxxxxxxxxxxxxx" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "moonshotai/kimi-k3.1-pro",
    "reasoning_effort": "low",
    "messages": [
      {"role": "user", "content": "Найди в этом логе причину таймаута: ..."}
    ]
  }'
То же на Python через официальный SDK OpenAI — меняется только base_url:
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://routerai.ru/api/v1",
    api_key=os.environ["ROUTERAI_API_KEY"],
)

resp = client.chat.completions.create(
    model="moonshotai/kimi-k3.1-pro",
    reasoning_effort="low",
    messages=[{"role": "user", "content": "Суммируй этот инцидент в три пункта: ..."}],
    max_tokens=2000,
)
print(resp.choices[0].message.content, resp.usage)
Два замечания по параметрам:
- Токены рассуждений входят в
completion_tokensи тарифицируются как выход; отдельно они видны вusage.completion_tokens_details.reasoning_tokens, аusage.costсразу показывает стоимость запроса в рублях. Мы проверили: на короткий вопрос модель потратила 127 токенов рассуждений из 150 выходных. -
temperatureв списке поддерживаемых параметров карточки не указан, но запрос сtemperature: 0.3принимается без ошибки.
📷 [Скриншот: ответ модели в веб-чате RouterAI (https://routerai.ru/chat) — в селекторе выбрана moonshotai/kimi-k3.1-pro, в поле ввода короткая задача по коду, в ответе виден текст и блок рассуждений]
Кому подходит
Берите K3.1 Pro, если агент часами работает в реальной кодовой базе: правит файлы, гоняет тесты, разбирает падения. По замерам Terminal-Bench результат на уровне Opus 5.5 при цене Sonnet 5.5. Второй сценарий — задачи, где миллион токенов нужен по-настоящему: навигация по монорепозиторию, разбор логов, анализ пакета документов.
Доплачивать за Opus 5.5 стоит, когда ошибка дороже токенов (миграция данных, правка в критичном модуле, аудит безопасности) и когда нужен результат с первой попытки без перепроверки: для K3 на DeepSWE (см. нашу статью) Claude Fable 5 был стабильнее на pass@1, а для K3.1 Pro мы такого сравнения не нашли — проверяйте на своих задачах. Ещё один случай — графика и скриншоты: Opus 5.5 в описании каталога отдельно выделен по чтению диаграмм и осторожности в утверждениях о цифрах, а на BenchCAD K3.1 Pro уступает и Opus, и GPT-6 Astra.
Не берите, если нагрузка — массовые короткие запросы: GLM-5.3 и DeepSeek V4 Flash решат их в разы дешевле, а на простых задачах разница в интеллекте не проявится.
Итог
K3.1 Pro — редкий случай, когда обновление линейки меняет не цену, а назначение. Kimi K3 была дешёвой альтернативой флагманам для задач, допускающих несколько попыток. K3.1 Pro переехала в категорию Sonnet 5.5 и конкурирует там уже по качеству: по агентным замерам обеих сторон она вплотную подошла к Opus 5.5, отставая по GDPval-AA на 20 Elo.
Практический вывод: если раньше вы выбирали между Kimi K3 и Sonnet 5.5 по цене, теперь выбор идёт по поведению на вашей задаче — прайс одинаковый. Нужен агент с длинным контекстом и вы готовы проверять результат, а не верить первому ответу — K3.1 Pro сильный кандидат. Задача разовая и дорогая — переплата за Opus 5.5 по-прежнему оправдана. Обзоры конкурентов: Gemini 4 Argon, Claude Haiku 5.5.
Kimi K3.1 Pro уже в каталоге RouterAI — с оплатой в рублях и без VPN. Создайте аккаунт и сравните модель с Sonnet 5.5 на своей задаче: стоят они одинаково, а ведут себя по-разному. Формат запросов — в быстром старте, про цену токенов и кэш — в глоссарии по token pricing, про уровни усилия рассуждений — в статье о reasoning-моделях, про открытые веса — в обзоре open-source моделей.