Reasoning-модели (модели рассуждения): что это и как управлять reasoning effort
Reasoning-модели (модели рассуждения) — это языковые модели, которые перед финальным ответом генерируют длинную промежуточную цепочку рассуждений: разбирают задачу, пробуют варианты, проверяют себя. На это они тратят дополнительные вычисления прямо во время ответа (test-time compute), поэтому отвечают дольше и дороже, но заметно точнее на сложных задачах.
Что это
Обычная instruct-модель (инструктивная модель) начинает писать ответ сразу. Reasoning-модель сначала «думает»: выпускает служебные reasoning-токены, и только потом формирует видимый ответ. Идея называется test-time compute: качество можно повышать не только обучением более крупной модели, но и тем, что модели дают больше токенов на размышление при инференсе.
Чем это отличается от соседних понятий:
- Instruct-модель без рассуждений отвечает за один проход; на многошаговой арифметике, логике и планировании чаще ошибается.
- Chain of Thought — приём промптинга: вы сами просите «рассуждай шаг за шагом». Модель при этом остаётся обычной, а рассуждения попадают в видимый ответ.
- Reasoning-модель обучена рассуждать сама, без специальной просьбы в промпте. Размышления идут в отдельном потоке, а глубиной можно управлять параметром API (reasoning effort).
Ещё один родственный метод — Tree of Thoughts, где перебор вариантов организует внешний алгоритм, а не сама модель.
Как работает
Обучение. В статье про DeepSeek-R1 показано, что способность к рассуждению можно стимулировать чистым обучением с подкреплением (RL) без размеченных человеком цепочек: модель получает награду за верный итог на задачах с проверяемым ответом (математика, соревновательное программирование, STEM), а самопроверка, возвращение к шагам и смена стратегии появляются в ходе обучения сами (arXiv 2501.12948).
Ответ. Схема «подумать, затем ответить»: модель генерирует reasoning-токены, затем видимый ответ. В документации OpenAI отмечено, что reasoning-токены не видны через API, но занимают место в контекстном окне и оплачиваются как выходные токены (Reasoning models). Часть провайдеров отдаёт рассуждения или их краткое изложение — это зависит от модели.
Управление глубиной. Параметр reasoning effort подсказывает модели, сколько думать. Набор значений зависит от модели; в документации OpenAI встречаются none, minimal, low, medium, high, xhigh, max. Низкий уровень экономит токены и время, высокий даёт более полный разбор. Модели рассуждают адаптивно: на простом вопросе они потратят меньше токенов, чем на сложном, даже при высоком effort.
В API RouterAI
RouterAI принимает reasoning-параметры в OpenAI-совместимом запросе https://routerai.ru/api/v1/chat/completions:
| Параметр | Что делает |
|---|---|
reasoning |
объект, например {"effort": "low"} — уровень рассуждений |
reasoning_effort |
то же самое «плоским» полем |
include_reasoning |
true — вернуть текст рассуждений в ответе, если модель его отдаёт |
curl https://routerai.ru/api/v1/chat/completions \
  -H "Authorization: Bearer sk-xxxxxxxxxxxxxxxx" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek/deepseek-v4-pro",
    "messages": [{"role": "user", "content": "Фермер собрал 3 корзины по 47 яблок и 2 по 38. 15% червивые. Сколько хороших?"}],
    "reasoning": {"effort": "low"},
    "include_reasoning": true,
    "max_tokens": 4000
  }'
Через OpenAI SDK нестандартные поля передают в extra_body:
from openai import OpenAI

client = OpenAI(base_url="https://routerai.ru/api/v1", api_key="sk-xxxxxxxxxxxxxxxx")
resp = client.chat.completions.create(
    model="deepseek/deepseek-v4-pro",
    messages=[{"role": "user", "content": "Сколько будет 17*24?"}],
    max_tokens=4000,
    extra_body={"reasoning": {"effort": "low"}, "include_reasoning": True},
)
msg = resp.choices[0].message
print(getattr(msg, "reasoning", None))                      # текст рассуждений, если отдан
print(resp.usage.completion_tokens_details.reasoning_tokens)  # сколько ушло на рассуждения
Как читать ответ. При include_reasoning: true в choices[0].message может появиться поле reasoning (а иногда и reasoning_details). Число токенов рассуждений — в usage.completion_tokens_details.reasoning_tokens. Эти токены уже входят в completion_tokens.
В наших проверочных запросах 26 октября 2026 года:
-
deepseek/deepseek-v4-proиmoonshotai/kimi-k3вернули текст рассуждений вreasoning; -
openai/gpt-5.6-lunaпри низком effort вернул краткое изложение, а при высоком — пустое поле, хотяreasoning_tokensбыл больше нуля; - у
anthropic/claude-opus-5текст рассуждений пришёл, ноreasoning_tokensостался нулевым — ориентируйтесь наcompletion_tokens; - неподдерживаемое значение effort даёт ошибку 400 с перечнем допустимых значений.
Для моделей Anthropic есть и нативный способ: в запросе к Anthropic Messages API (https://routerai.ru/api/v1/messages) передают "thinking": {"type": "enabled", "budget_tokens": 2048}, а в ответе приходит блок thinking перед блоком text (проверено на anthropic/claude-opus-5).
Не рассчитывайте, что рассуждения вернутся всегда: сохраняйте логику, которая работает и без поля reasoning. Общие параметры запроса — в документации RouterAI.
Какие модели поддерживают
Источник правды — каталог и поле supported_parameters в https://routerai.ru/api/v1/models: если там есть reasoning (и reasoning_effort), модель принимает эти параметры. В каталоге такие модели отбираются фильтром «Поддерживаемые параметры» (reasoning, include_reasoning).
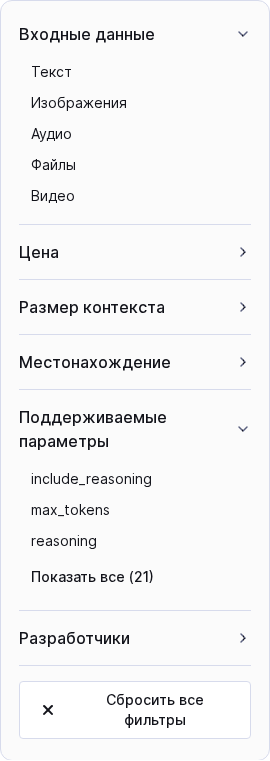
На 26 октября 2026 года флаг reasoning есть примерно у 250 из 575 моделей каталога, поэтому ниже — выборка. Цены за 1M токенов вывода взяты из каталога.
| Модель | reasoning_effort |
Вывод, ₽ / 1M | Для чего |
|---|---|---|---|
deepseek/deepseek-v4-flash |
да | 19,9 | дешёвые рассуждения на объёме |
deepseek/deepseek-v4-pro |
да | 219,9 | математика, код, анализ |
openai/gpt-5.6-luna |
да | 125,6 | быстрые и недорогие задачи |
openai/gpt-5.6-terra |
да | 1256,4 | сбалансированное решение |
openai/gpt-5.6-sol |
да | 2094,0 | верхний уровень серии GPT-5.6 |
anthropic/claude-opus-5 |
да | 2617,5 | длинные задачи с кодом и агентами |
moonshotai/kimi-k3 |
да | 575,8 | открытая reasoning-модель |
У семейства gpt-5.6 есть и варианты -pro. Часть моделей имеет флаг reasoning, но не принимает reasoning_effort (например, deepseek/deepseek-r1-0528): рассуждения у них встроены, и глубину через этот параметр не задать.
Где применяется
Reasoning оправдан там, где ошибка дороже лишних токенов:
- математика и логика — многошаговые расчёты, доказательства;
- код — отладка, рефакторинг, поиск причины сбоя;
- планирование и агенты — выбор последовательности действий и инструментов;
- анализ документов — сверка условий, поиск противоречий.
Для оценки моделей на таких задачах смотрите рейтинги и бенчмарки, но проверяйте их на своих данных.
Цена вопроса
Reasoning-токены оплачиваются по тарифу выходных токенов (Output Tokens), а выход обычно дороже входа. Поэтому ответ из одной строки может стоить как страница текста.
Пример на deepseek/deepseek-v4-pro (одна задача, один прогон): с effort: "none" модель вернула около 340 токенов без рассуждений, с effort: "high" — около 2060, из них 1778 на рассуждения. Поле usage.cost в ответах показало разницу примерно в 6 раз (цена вывода у модели одна — 219,9 ₽ за 1M токенов по каталогу). Конкретная кратность зависит от задачи и модели. Общая формула расчёта — в статье про стоимость токенов.
Типичные ошибки
-
Reasoning на классификации, извлечении полей и чатах поддержки. Задача не требует размышлений — вы платите за токены, которые не улучшают результат. Берите быструю модель или
effortпониже. -
Цена считается только по видимому ответу. Токены рассуждений входят в
completion_tokens— сверяйте расходы с полемusage. -
Слишком малый
max_tokens. Лимит делят рассуждения и ответ. В проверке сmax_tokens: 300наdeepseek/deepseek-v4-proиeffort: "high"все 300 токенов ушли на рассуждения:finish_reasonбылlength, аcontentпустым. OpenAI советует закладывать не менее 25 000 токенов на рассуждения и вывод при первых экспериментах. -
Высокий effort «на всякий случай». Начните с
lowилиmediumи повышайте, пока качество на ваших примерах растёт. - Ставка на текст рассуждений. Провайдеры могут отдавать лишь краткое изложение или ничего.
Связанные термины
- Chain of Thought (CoT) — рассуждения через промпт
- Tree of Thoughts — перебор вариантов рассуждения
- Инференс ИИ-моделей — этап, на котором тратится test-time compute
- Output Tokens — по этому тарифу идут reasoning-токены
- Спекулятивное декодирование — способ ускорить генерацию длинных ответов, в том числе с рассуждениями
- Рейтинг нейросетей (LLM Benchmarks) — как сравнивают модели
- Каталог моделей RouterAI — доступ из России без VPN, оплата в рублях