
Compaction (сжатие контекста): как агенты укладывают задачу в окно модели
Compaction (сжатие контекста) — это приёмы, которыми агент удерживает историю диалога в пределах окна модели и в пределах качества ответа: старую часть переписки сворачивают в короткую сводку, шумные результаты инструментов выбрасывают, а важное переносят в файлы. Модель продолжает работу не с полной стенограммой, а с выжимкой.
Compaction — это часть более широкого контекст-инжиниринга. Разница простая: context engineering проектирует весь вход модели — промпт, инструменты, файлы, память, порядок блоков, — а compaction занимается одной конкретной частью: историей диалога, которая растёт на каждом шаге агента.
Зачем сжимать, если окна хватает
У современных моделей окно в миллион токенов, и соблазн держать в нём всю сессию целиком велик. Anthropic в статье про контекст-инжиниринг прямо предупреждает: ждать, пока окна станут больше, — плохая стратегия, потому что окно любого размера страдает от загрязнения контекста и падения релевантности (Anthropic Engineering).
Две причины сжимать историю.
- Качество. Чем длиннее вход, тем хуже модель вытаскивает нужное из середины — это эффект context rot. Агент с сотней шагов и 300 тысячами токенов истории начинает терять детали задачи, и compaction нужен не ради лимита, а чтобы вернуть модели читаемый рабочий набор токенов.
- Цена. В агентном цикле вход отправляется заново на каждом шаге. История на 100 тысяч токенов оплачивается столько раз, сколько раундов делает агент. Подсчёты на живых задачах собраны в статье «Сколько стоит агентная сессия».
Типичная агентная сессия — 50–100 шагов, и на длинных задачах она упирается в окно регулярно, а не только в исключительных случаях.
Как это работает
Автоматическое сжатие в Claude Code
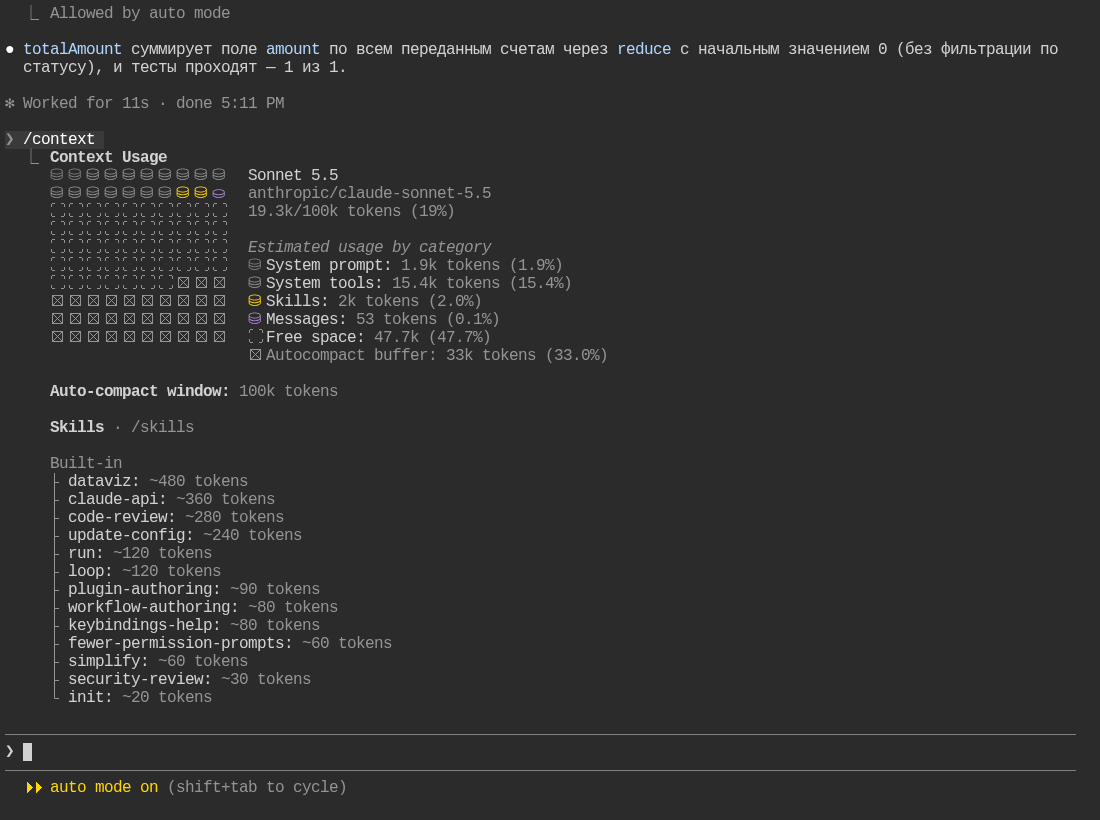
Claude Code сжимает историю сам, когда контекст подходит к пределу. Порог зависит от модели: у моделей с нативным окном 1M сжатие срабатывает примерно на 967 тысячах токенов, у остальных — у границы окна; при включённом ограничении 1M-контекста — на 200K (документация Claude Code). Посмотреть расход и границы можно командой /context: она показывает занятые токены, свободное место и зарезервированный буфер под автосжатие.
Окно компактирования настраивается: autoCompactWindow в ~/.claude/settings.json, команда /autocompact 500k для текущей модели или переменная CLAUDE_CODE_AUTO_COMPACT_WINDOW. Допустимый диапазон — от 100K до 1M токенов, значение обрезается по окну модели.
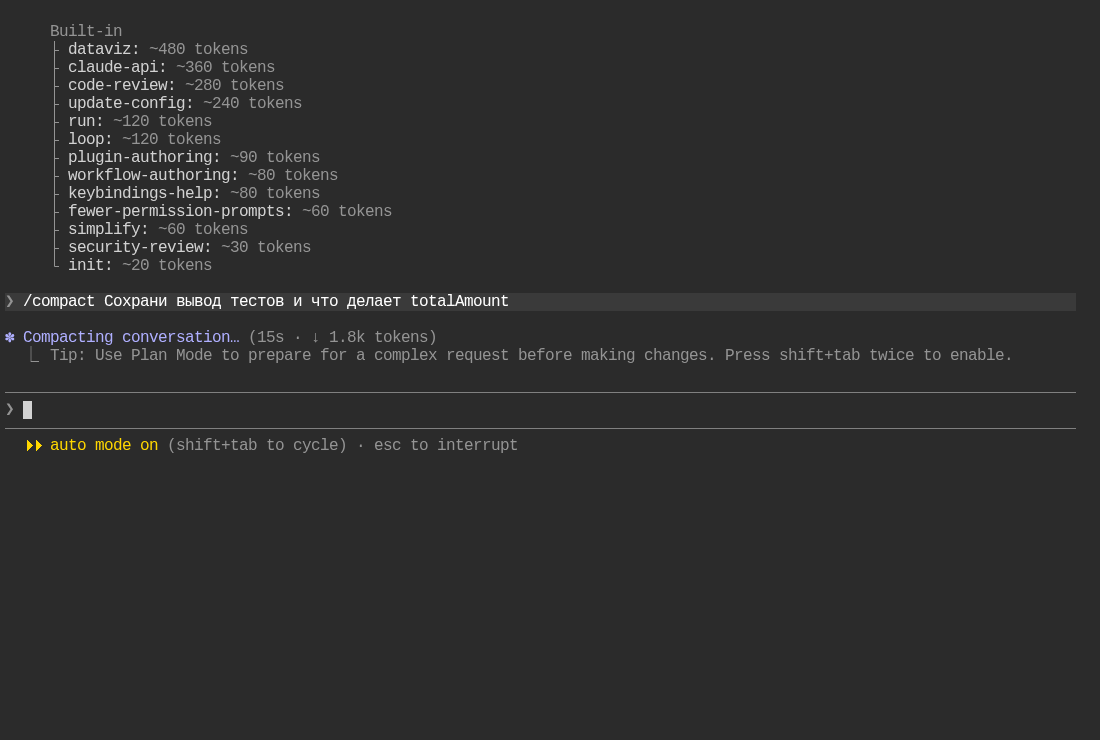
Что Claude Code сохраняет при сжатии, Anthropic описывает так: архитектурные решения, нерешённые баги и детали реализации, а отбрасывается повторяющийся вывод инструментов; после сжатия агент продолжает работу с пятью последними открытыми файлами. Ручной вариант — /compact с указанием, что именно важно сохранить.
Автосжатие в Codex
В Codex CLI порог сжатия задаётся в ~/.codex/config.toml ключом model_auto_compact_token_limit, а полный размер окна — model_context_window. Ключ model_auto_compact_token_limit_scope определяет, что считать: весь активный контекст (total, по умолчанию) или только прирост после последнего сжатия (body_after_prefix). Есть и model_post_turn_compact_threshold_percent — доля окна, при которой сжатие запускается после финального ответа хода (схема конфигурации Codex).
Устройство отличается от «перескажи стенограмму клиентом». По разбору исходников Codex, клиент отправляет обычный запрос с полной историей и специальным маркером, а сервер возвращает непрозрачный блок со сжатым состоянием; клиент сохраняет сообщения пользователя дословно (в пределах лимита в 64 тыс. токенов) и заново подставляет инструкции, а объём переписки ассистента и вызовов инструментов сворачивается. Для провайдеров без такого протокола Codex сжимает историю локальным промптом.
Другие приёмы
- Ручная суммаризация. Команда с указанием, что сохранить, или отдельный запрос «сведи историю до решений и открытых задач» перед продолжением.
- Выбрасывание старых tool-результатов. Самый мягкий и безопасный приём: сырой вывод инструмента из глубины истории не нужен — файл можно прочитать снова. Anthropic называет очистку результатов инструментов самой лёгкой формой сжатия и вынес её в отдельную функцию платформы.
- Дедупликация и сжатие логов и JSON. Одинаковые строки журналов, повторяющиеся поля JSON и одинаковые блоки кода режутся почти без потерь. Инструменты вроде Headroom делают это отдельным слоем перед отправкой запроса: заявленная экономия на повторяющихся JSON-массивах и строках логов превышает 90%, на обычном тексте она близка к нулю.
-
Заметки в файл вместо «держать всё в промпте». Anthropic называет это структурированной заметкой-памятью: агент пишет в
NOTES.mdилиAGENTS.mdпрогресс, договорённости и открытые вопросы, а после сжатия или новой сессии перечитывает файл. В Claude Code для этого естьCLAUDE.mdи auto memory, подробнее — в статье Agent Memory. -
Сжатие с возможностью запросить оригинал (CCR, compress-cache-retrieve). Сжатый вариант отдаётся модели, а исходный текст хранится локально, и модель может подтянуть его инструментом, если выжимки не хватило. Так устроен Headroom:
headroom_retrieveвозвращает полный фрагмент по запросу.
Что теряется при сжатии
Сводка по определению неполна. Обычно теряются:
- точные тексты ошибок и трассировки стека;
- полные пути к файлам и номера строк;
- промежуточные версии кода и вывод команд;
- детали, важность которых выяснится через двадцать шагов.
Anthropic прямо предупреждает: слишком агрессивное сжатие теряет тонкий, но критичный контекст, и рекомендует сначала настроить промпт сжатия на реальных трассах агента так, чтобы он ловил всё существенное, а потом уже убирать лишнее.
Компенсируют это артефактами на диске. Если результат нужен позже, его пишут в файл: test-output.log, plan.md, NOTES.md. Тогда сводке достаточно сослаться на путь, а агент перечитает файл, когда понадобится. Отсюда практическое правило: в сводке держат решения и ссылки, а не полные данные.
Как измерять эффект
-
Доля входа, занятая историей. В Claude Code это видно в
/context: сколько занимают сообщения, системный промпт, инструменты и буфер. - Число раундов до результата. Сжатие, которое экономит токены, но добавляет десять лишних шагов, обычно проигрывает.
- Доля повторных чтений файла. Если агент снова и снова открывает один и тот же файл, значит, сжатие выбросило нужную деталь.
- Расход в личном кабинете RouterAI. Стоимость запросов и токены по моделям видны в разделе статистики; по ним удобно сравнивать сессии с разным устройством контекста.
Compaction и кэширование промптов
Это разные механизмы, и путать их не стоит. Кэширование промптов не уменьшает вход: оно удешевляет повторную отправку того же префикса. Compaction уменьшает сам вход, но ломает префикс: после сжатия история другая, и кэш приходится строить заново — Claude Code даже считает такой промах ожидаемой перестройкой кэша.
Поэтому они дополняют друг друга. Стабильную часть — системный промпт, описания инструментов, правила проекта — держат в начале и кэшируют. Растущую историю сжимают по порогу. Порядок действий получается такой: сначала очистка старых результатов инструментов, потом сжатие истории, а не наоборот.
Связь с RouterAI
Compaction — функция агентской обвязки, а не модели: через API приходит обычный запрос, и какой именно контекст в него попал, решает клиент. Для RouterAI это означает, что любой агент, настроенный на https://routerai.ru/api/v1 (OpenAI-совместимый) или https://routerai.ru/api (Anthropic Messages), работает со сжатием так же, как с прямым провайдером. Подключение Claude Code описано в статье Claude Code через RouterAI, Codex — в статье Codex через RouterAI.
Большое окно не отменяет сжатие. Модели с окном 1M токенов в каталоге — deepseek/deepseek-v4.1-flash, qwen/qwen3.6-flash, z-ai/glm-5.3 — вмещают длинную сессию, но не спасают от context rot и не отменяют оплату всех этих токенов на каждом шаге.
Разница видна на арифметике. Задача из 40 шагов при входе 100 тыс. токенов на шаг — это 4 млн входных токенов, при входе 30 тыс. — 1,2 млн. По ценам каталога на ноябрь 2026 года вход на deepseek/deepseek-v4.1-flash стоит 8,81 ₽ за 1 млн токенов, то есть около 35 ₽ против 11 ₽ за задачу; на anthropic/claude-sonnet-5.5 при 213,56 ₽ за 1 млн — около 854 ₽ против 256 ₽. Выходные токены и кэш в расчёт не входят, актуальные цены — в каталоге.
Что почитать
- Effective context engineering for AI agents — Anthropic о compaction, заметках и субагентах
- Model configuration — Claude Code Docs — окно автосжатия и пороги по умолчанию
-
Codex config schema — ключи
model_auto_compact_token_limitи соседние -
Claude Code как daily driver — практика работы с
CLAUDE.md, skills и субагентами - Headroom на GitHub — сжатие истории и CCR-подход
Связанные термины
- Context Window — что такое контекстное окно
- Context rot — почему длинный контекст не равен умному ответу
- Контекст-инжиниринг — проектирование всего входа модели
- Prompt Caching — как кэш удешевляет повторный префикс
- Agent Memory — память агента за пределами окна
- Захват контекста — подгрузка данных по требованию