Semantic Caching: семантический кэш для LLM
Semantic Caching (семантическое кэширование) — это кэш ответов языковой модели, который срабатывает не по точному совпадению строки запроса, а по смыслу: новый вопрос превращается в эмбеддинг, ищется среди сохранённых, и если близость выше порога, пользователь получает готовый ответ без обращения к модели.
Обычный кэш отвечает только на тот же ключ: поменялась буква — промах. А один и тот же вопрос люди задают десятками формулировок — такой запрос семантический кэш и склеивает.
Что это
Ключом становится не строка, а вектор смысла: кэш хранит пары «эмбеддинг вопроса → ответ модели» и при новом запросе ищет ближайшего соседа в векторном индексе.
Отличие от кэширования промптов принципиальное. Prompt Caching работает на стороне провайдера: он запоминает вычисленные состояния (KV-кэш) для префикса запроса — системной инструкции, длинного документа, истории диалога. Экономия идёт на входных токенах, а генерация ответа происходит каждый раз. Семантический кэш стоит на стороне приложения и экономит целиком запрос: при попадании модель не вызывается вовсе.
| Кэш по ключу | Prompt Caching | Семантический кэш | |
|---|---|---|---|
| Где живёт | приложение | провайдер | приложение |
| Что совпадает | точная строка запроса | префикс | смысл вопроса |
| Что экономит | весь вызов | входные токены префикса | весь вызов |
| Когда не сработает | вопрос переформулирован | изменилось начало промпта | смысл ушёл за порог |
| Риск | нет | нет | ответ не на тот вопрос |
С третьей схемой его путают: локальный кэш SDK кладёт ответ на диск или в Redis по хешу запроса — это обычный кэш по ключу, просто ближе к коду.
Как работает
Пять шагов на каждый запрос:
-
Эмбеддинг. Текст уходит в модель эмбеддингов и превращается в вектор —
qwen/qwen3-embedding-8bотдаёт 4096 чисел. - Поиск. Вектор ищется среди сохранённых в векторной базе данных — pgvector, Qdrant, Milvus, FAISS. На больших объёмах — приближённый поиск (ANN): долей точности жертвуют ради скорости.
- Порог. Лучший кандидат сравнивается по косинусной близости с порогом: выше — попадание, ниже — промах.
- Hit. Возвращается сохранённый ответ, модель не вызывается.
- Miss. Запрос уходит в модель, а ответ пишется в кэш вместе с эмбеддингом, TTL и метаданными: модель, версия системного промпта, тенант. Сменилась модель или промпт — старые ответы не отдают, кэш инвалидируют.
Так устроена открытая библиотека GPTCache: адаптер LLM, генератор эмбеддингов, менеджер кэша, оценщик сходства, постобработчик.
Где применять
Окупается там, где вопросы повторяются, а ответы не зависят от пользователя: FAQ-боты и первая линия поддержки, вопросы к документации, дорогие reasoning-модели, где один ответ стоит куда больше эмбеддинга и поиска.
Ломается там, где ответ обязан быть новым:
- Творческие задачи и код. Повторный ответ нежелателен, а похожий вопрос в другом репозитории требует другого ответа: код проекта в эмбеддинг не входит.
- Запросы с датами и состоянием. «Какие акции действуют сейчас», «статус моего заказа» — кэш отдаст устаревшее.
- Запросы с параметрами пользователя — см. следующий раздел.
Риски
Персональные данные. Главная опасность: если в кэш попал ответ «какой у меня баланс» с данными одного клиента, второй клиент с похожим вопросом получит его же. В кэш идёт только то, что не зависит от пользователя: без персональных данных, документов из личного кабинета и запросов с идентификатором сессии.
Цена порога. Занизили — кэш отвечает не на тот вопрос (false positive). Завысили — кэш почти не срабатывает, и эмбеддинг каждого запроса уходит впустую. В экспериментах авторов GPTCache порог 0.7 дал на 1 000 запросов 876 попаданий, из которых 39 были ошибочными. Даже «хороший» порог пропускает мусор: его подбирают по своим данным, а не копируют.
Устаревание и экономика. Ответ в кэше живёт дольше факта, на котором основан: TTL нужен всем записям, для цен и сроков — короткий. Кэш выгоден только при частых попаданиях — иначе вы платите за эмбеддинг каждого запроса и содержите векторную базу без отдачи.
Связь с RouterAI
RouterAI даёт OpenAI-совместимый API https://routerai.ru/api/v1: генерация и эмбеддинги идут через один ключ, оплата в рублях, работа из России без VPN.
| Модель эмбеддингов | Размерность | Когда брать |
|---|---|---|
qwen/qwen3-embedding-8b |
4096 | основной вариант: многоязычная, контекст до 40 960 токенов |
openai/text-embedding-3-small |
1536 | компактный индекс, короткие вопросы |
google/gemini-embedding-001 |
3072 | совместимость с готовым индексом Google |
Векторы двух разных моделей нельзя держать в одном индексе: расстояния между ними ничего не значат, при смене модели кэш перестраивают целиком.
import math
import os
from openai import OpenAI

client = OpenAI(
    base_url="https://routerai.ru/api/v1",
    api_key=os.environ["ROUTERAI_API_KEY"],
)

CACHE = []  # в продакшене — таблица в pgvector или коллекция в Qdrant


def embed(text: str) -> list[float]:
    resp = client.embeddings.create(model="qwen/qwen3-embedding-8b", input=text)
    return resp.data[0].embedding


def cosine(a: list[float], b: list[float]) -> float:
    dot = sum(x * y for x, y in zip(a, b))
    norm = math.sqrt(sum(x * x for x in a)) * math.sqrt(sum(y * y for y in b))
    return dot / norm


def answer(question: str, threshold: float = 0.85) -> str:
    vec = embed(question)
    best_score, best_reply = 0.0, None
    for cached_vec, _, cached_reply in CACHE:
        score = cosine(vec, cached_vec)
        if score > best_score:
            best_score, best_reply = score, cached_reply
    if best_reply is not None and best_score >= threshold:
        return f"HIT  {best_score:.3f}  {best_reply[:50]}"
    resp = client.chat.completions.create(
        model="anthropic/claude-haiku-5.5",
        messages=[{"role": "user", "content": question}],
        max_tokens=120,
    )
    reply = resp.choices[0].message.content
    CACHE.append((vec, question, reply))
    return f"MISS {best_score:.3f}  {reply[:50]}"


for q in [
    "Как оформить возврат товара?",
    "Как вернуть товар?",
    "Сколько идёт доставка в Казань?",
    "Какие сроки доставки в Казань?",
    "Напиши стихотворение про осень",
]:
    print(f"{q:40} | {answer(q)}")
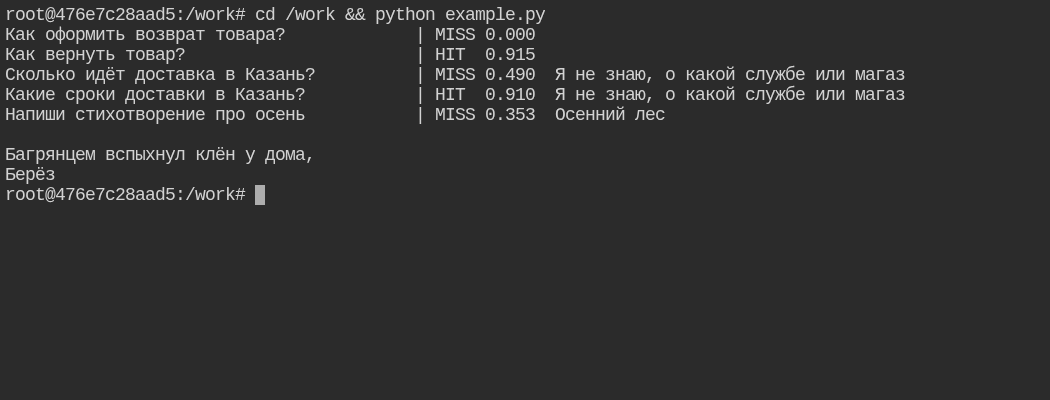
В этом прогоне «Как вернуть товар?» попало в кэш с близостью 0.915, перефразированный вопрос про доставку — с 0.910, а исходный вопрос про доставку (0.490) и просьба про стихотворение (0.353) ушли в модель.
Эффект измеряют двумя метриками: hit rate — доля запросов, закрытых кэшем, и сэкономленные токены. Обе сводятся к деньгам через расчёт стоимости токенов, расход виден в аналитике по токенам. Входной токен qwen/qwen3-embedding-8b примерно в 200 раз дешевле токена anthropic/claude-sonnet-5.5: промах стоит одного лишнего эмбеддинга, попадание экономит весь ответ. Другие способы сократить расход — в статье про экономию на API-запросах.
Связанные термины
- Кэширование промптов (Prompt Caching) — экономия на префиксе запроса у провайдера
- Векторные эмбеддинги — из чего состоит ключ семантического кэша
- Векторная база данных — где живёт индекс и как ищется ближайший сосед
- Semantic Search — тот же поиск по смыслу, но по документам, а не по ответам
- Аналитика расхода токенов — как измерить долю запросов, закрытых кэшем
Что почитать
- GPTCache: An Open-Source Semantic Cache for LLM Applications Enabling Faster Answers and Cost Savings — статья о библиотеке, NLP-OSS 2023
- Yet another cache, but for ChatGPT — устройство GPTCache и почему не подошёл Redis