
Реренкинг (Reranking): что это и зачем нужен второй этап поиска в RAG
Реренкинг (Reranking, переранжирование) — это второй этап поиска, на котором модель-реранкер заново упорядочивает уже найденные документы по релевантности к запросу. Быстрый поиск отбирает, например, 50 кандидатов, а реранкер ставит самый подходящий на первое место.
Реренкинг чаще всего встречается в RAG: от того, какие фрагменты попадут в промпт, зависит ответ LLM. Реранкер не генерирует текст, а только оценивает пары «запрос — документ», поэтому стоит заметно дешевле и работает быстрее LLM.
Зачем нужен второй этап
Векторный поиск использует bi-encoder: запрос и каждый документ превращаются в эмбеддинги по отдельности, а близость считается по векторам. Документы можно закодировать заранее и искать по индексу за миллисекунды. Цена скорости — потеря деталей: весь смысл фрагмента сжат в один вектор, и тонкие различия («вернуть деньги за подписку» и «вернуть товар в магазин») могут оказаться рядом.
Cross-encoder читает запрос и документ вместе, как одну последовательность, и видит, как слова запроса связаны с текстом. Это точнее, но модель нужно запускать для каждой пары заново, и по всей базе это слишком дорого. Отсюда двухступенчатая схема:
- Recall. Дешёвый поиск (векторный, по ключевым словам или гибридный) достаёт широкий список кандидатов: топ-50 или топ-100. Важно, чтобы нужный документ вообще попал в список.
- Rerank. Реранкер оценивает только этих кандидатов, и в LLM уходят несколько лучших.
Как это работает
Для каждой пары «запрос + документ» cross-encoder выдаёт оценку релевантности (score). Документы сортируются по ней. В API реранкера на вход приходят запрос и список документов, на выход — список индексов исходных документов с оценками. У моделей Cohere Rerank 5 оценки калиброваны в диапазоне от 0 до 1, поэтому можно задать порог и отбрасывать слабые фрагменты. Параметр top_n ограничивает число возвращаемых результатов.
В RouterAI реранк вызывается запросом POST https://routerai.ru/api/v1/rerank:
{
  "model": "cohere/rerank-5-fast",
  "query": "как оформить возврат средств",
  "documents": ["Текст первого фрагмента", "Текст второго фрагмента"],
  "top_n": 5
}
В ответе в results приходят index (позиция документа во входном списке), relevance_score и сам document, а в usage — число токенов для расчёта стоимости.
Реранкеры в каталоге RouterAI
В каталоге есть реранкеры Cohere двух классов. Оба принимают текст и имеют контекст 32 768 токенов (в каталоге округлено до 33K).
| Модель | Класс | Когда брать | Входящие токены за 1M, ₽ |
|---|---|---|---|
cohere/rerank-5-pro |
Pro, выше точность | Сложные запросы, длинные и узкоспециальные документы, в LLM уходит мало фрагментов | 5,34 |
cohere/rerank-5-fast |
Fast, ниже задержка | Большой поток запросов, циклы агентов, первичная фильтрация | 2,14 |
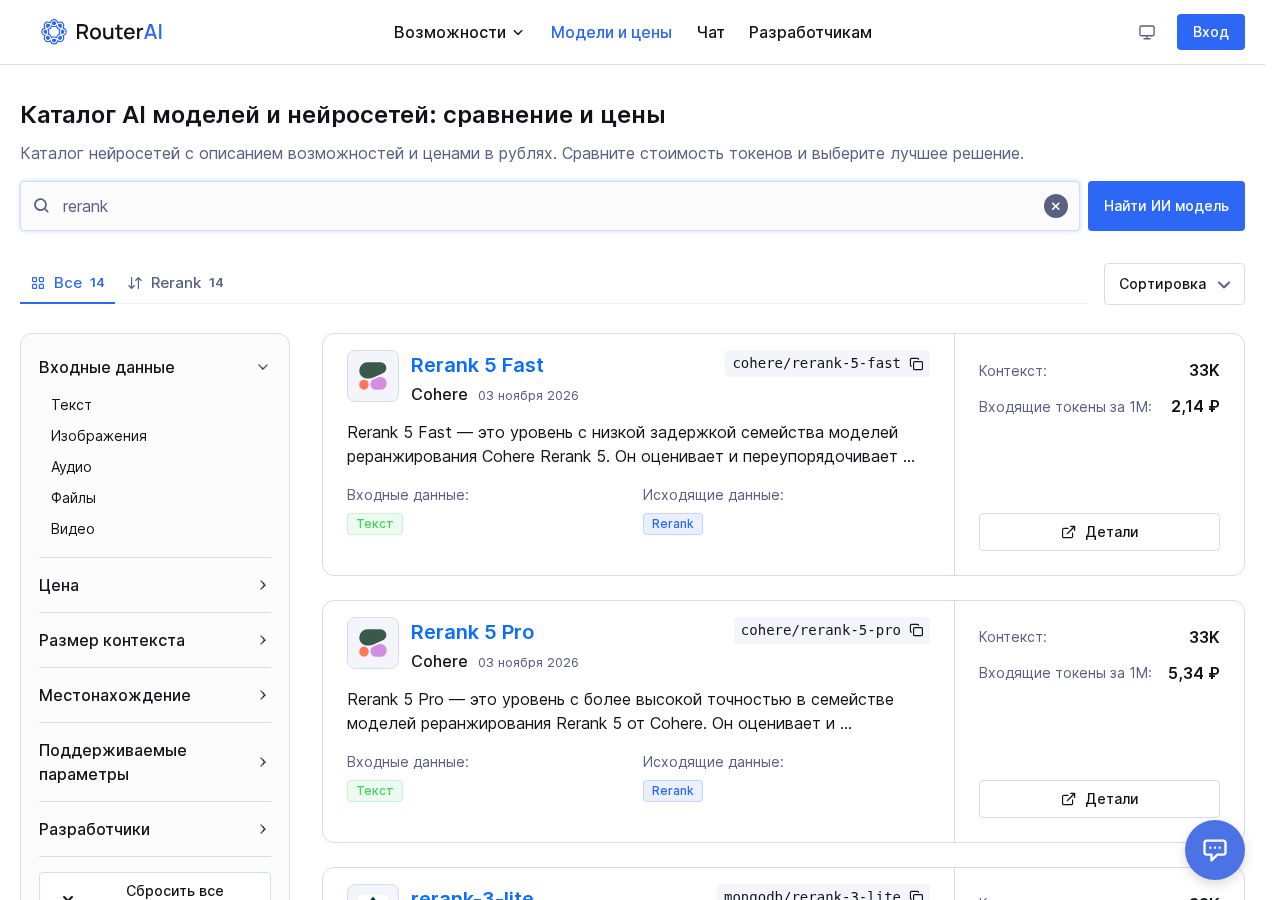
Цены даны по каталогу на 9 ноября 2026 года, актуальные значения смотрите на странице моделей. Реранк тарифицируется по токенам запроса и документов. Если в запрос уходит 50 фрагментов по 200 токенов, это около 10 000 токенов: примерно 0,02 ₽ на Fast и 0,05 ₽ на Pro. Начните с Fast, а на Pro переходите, если на вашем наборе вопросов качество не устраивает. В каталоге есть и другие реранкеры того же назначения, например voyageai/rerank-2.5 и mongodb/rerank-3.
Как встроить в RAG
Схема на RouterAI: эмбеддинги (cohere/embed-5-pro или cohere/embed-5-fast) → поиск в векторной базе → реранк → LLM для ответа (Claude, GPT или DeepSeek из каталога). Модели Embed 5 Pro и Fast делят одно пространство эмбеддингов: корпус можно проиндексировать на Pro, а запросы кодировать на Fast. Качество фрагментов зависит и от чанкинга: реранкер лучше работает с самодостаточными кусками текста.
В примере базы нет: близость считается в Python, но на этом месте стоит запрос к вашей векторной БД.
import os
import requests
from openai import OpenAI

BASE = "https://routerai.ru/api/v1"
KEY = os.environ.get("ROUTERAI_API_KEY", "sk-xxxxxxxxxxxxxxxx")
client = OpenAI(base_url=BASE, api_key=KEY)

docs = [
    "Возврат средств за подписку оформляется в личном кабинете в разделе «Платежи».",
    "Оплата принимается картами российских банков и через СБП.",
    "Техническая поддержка отвечает по будням с 9 до 18 по Москве.",
    "Восстановление пароля делается по ссылке «Забыли пароль» на странице входа.",
    "В тариф Business включены пять рабочих мест и приоритетная очередь запросов.",
]
query = "как оформить возврат средств"

# 1. Эмбеддинги: документы и запрос
doc_vecs = [e.embedding for e in client.embeddings.create(
    model="cohere/embed-5-fast", input=docs,
    extra_body={"input_type": "search_document"},
).data]
q_vec = client.embeddings.create(
    model="cohere/embed-5-fast", input=[query],
    extra_body={"input_type": "search_query"},
).data[0].embedding

# 2. Первый этап: top-50 по косинусной близости (в проекте это делает векторная БД)
def cos(a, b):
    dot = sum(x * y for x, y in zip(a, b))
    return dot / (sum(x * x for x in a) ** 0.5 * sum(y * y for y in b) ** 0.5)

order = sorted(range(len(docs)), key=lambda i: -cos(q_vec, doc_vecs[i]))[:50]
candidates = [docs[i] for i in order]

# 3. Второй этап: реранк до top-5
resp = requests.post(
    f"{BASE}/rerank",
    headers={"Authorization": f"Bearer {KEY}"},
    json={
        "model": "cohere/rerank-5-fast",
        "query": query,
        "documents": candidates,
        "top_n": 5,
    },
    timeout=60,
)
resp.raise_for_status()
top = [candidates[r["index"]] for r in resp.json()["results"]]

# 4. Ответ: в LLM уходят только лучшие фрагменты
context = "\n\n".join(top)
answer = client.chat.completions.create(
    model="anthropic/claude-sonnet-5.5",
    messages=[{
        "role": "user",
        "content": f"Ответь на вопрос, используя только фрагменты ниже.\n\n{context}\n\nВопрос: {query}",
    }],
)
print(answer.choices[0].message.content)
Реранк сокращает контекст: вместо 50 фрагментов в LLM идут 5, и вы платите за меньшее число входных токенов. Если RAG строит агент, который сам решает, что и когда искать, реранк подключается к каждому его поиску — см. Agentic RAG.
Когда реранкинг не нужен
- Маленькая база. Если в ней десятки документов, их можно целиком положить в контекст LLM.
- Точные ключевые слова. Артикулы, коды ошибок, названия функций надёжно находит обычный полнотекстовый поиск.
- Жёсткий бюджет. Реранк добавляет расходы на каждый запрос, пусть и небольшие.
- Критична задержка. Это ещё один сетевой вызов между поиском и ответом. Если важна каждая сотня миллисекунд, сначала измерьте, во что он обходится на ваших данных.
- Нужный документ не попадает в кандидаты. Реранкер лишь переставляет найденное. Если проблема в recall, чините поиск, чанкинг или запрос.
Метрики
Качество поиска оценивают по эталонной разметке «запрос — релевантные документы». Три основные метрики:
- recall@k — какая доля всех релевантных документов попала в первые k результатов.
- MRR (Mean Reciprocal Rank) — среднее значение 1/позиция первого верного документа.
- nDCG@k — учитывает позиции всех релевантных документов: чем выше они стоят, тем лучше оценка (от 0 до 1).
Для реранка важнее nDCG@k и precision в первых позициях: именно их он должен поднять. О метриках оценки моделей в целом — в статье Метрики оценки качества LLM.
С реранкингом и без: пример
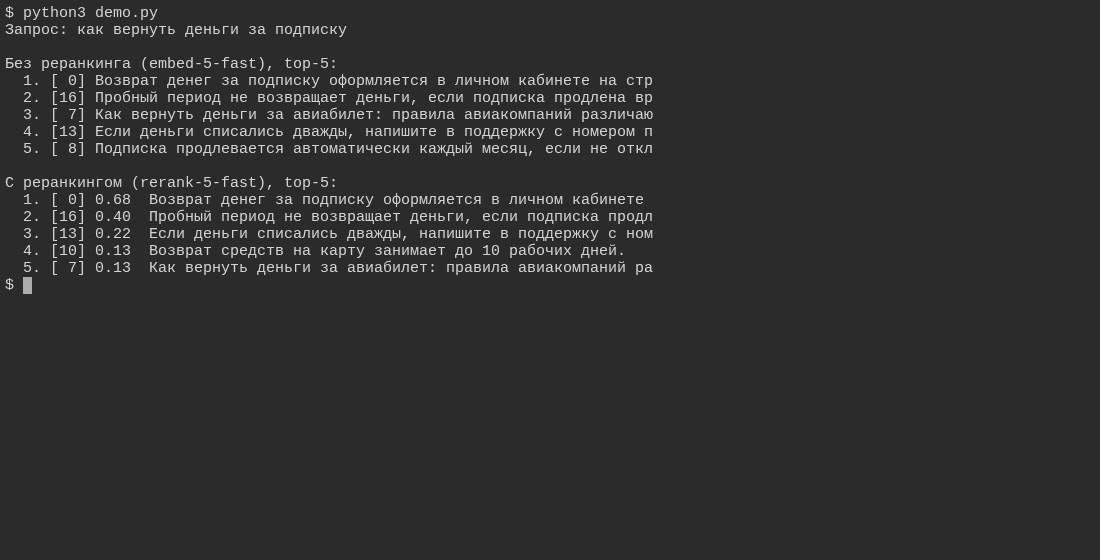
Пример на мини-наборе из 20 коротких фрагментов о платежах и подписках: четыре из них отвечают на запрос «как вернуть деньги за подписку». Первый этап — cohere/embed-5-fast и косинусная близость, второй — cohere/rerank-5-fast. Метрики считаются по первым пяти результатам.
| Показатель | Без реранкинга | С реранкингом |
|---|---|---|
| nDCG@5 | 0,39 | 0,56 |
| recall@5 | 0,25 | 0,50 |
| MRR | 1,0 | 1,0 |
| Фрагментов в промпте LLM | 5 | 5 |
| Доп. стоимость реранка на запрос (50 кандидатов по ~200 токенов) | 0 | около 0,02 ₽ |
Один запрос и 20 документов не доказывают общего прироста: цифры только показывают механику. MRR в обоих случаях равен 1,0, потому что точный ответ уже стоял первым, а выросла полнота первой пятёрки. На реальной базе прирост зависит от корпуса и языка, поэтому соберите 30–50 своих запросов с разметкой, посчитайте метрики с реранкером и без и сравните выигрыш с расходами.