LLM-as-a-Judge (ИИ в роли судьи): что это и как оценивать ответы нейросетью
LLM-as-a-Judge — это способ автоматически оценивать ответы языковой модели другой языковой моделью: ей дают вопрос, ответ и рубрику с критериями, а на выходе получают оценку или вердикт в машинно-читаемом виде.
Метрики вроде BLEU и ROUGE сравнивают текст с эталоном по совпадающим словам. Как только задача перестаёт быть переводом или изложением, эталон теряет смысл: у хорошего ответа на открытый вопрос нет единственной правильной формулировки. LLM-as-a-Judge решает эту проблему тем, что вместо подсчёта n-грамм использует модель, которая читает ответ и выносит суждение по заданным критериям — так же, как это делал бы человек-асессор, только быстрее и дешевле.
Что это
LLM-as-a-Judge (ИИ в роли судьи) — подход, при котором качество ответа одной модели оценивает другая модель по заранее описанной рубрике. Оценщик (judge) получает на вход вопрос пользователя, ответ, который нужно проверить, и инструкцию: какие критерии важны, по какой шкале ставить балл и в каком виде вернуть результат.
Ключевое отличие от обычного запроса к модели — в том, что на выходе нужен не текст, а измеримая величина: число от 0 до 5, пара pass/fail или выбор из двух вариантов. Именно поэтому судью почти всегда просят отвечать в структурированном виде — см. Structured Output.
Зачем это нужно на практике:
- Регрессии. После смены промпта, модели или чанкинга в RAG нужно понять, стало лучше или хуже. Судья прогоняет весь набор тестовых вопросов и даёт сравнимые числа.
- Разметка без человека. Оценка сотен диалогов вручную стоит дорого и занимает много времени; судья проходит тот же объём автоматически.
- Выбор между вариантами. Две версии промпта сравниваются на одних и тех же примерах, и решение принимается по данным, а не по впечатлению от трёх показательных ответов.
У подхода есть измеренная точность. В работе Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena сильный судья согласовывался с оценками людей более чем в 80% случаев — примерно на том же уровне, что и люди между собой. Это не абсолютная истина, а инструмент с известной погрешностью.
Как работает
Судья — это обычный вызов чат-модели, у которого специально устроен промпт. В нём есть четыре части:
- Роль и правило. «Ты оцениваешь ответы ассистента. Оценивай только по критериям ниже, не по общему впечатлению».
- Рубрика. Критерии, шкала и описание того, что означает каждый балл.
- Материал. Вопрос пользователя, ответ тестируемой модели, при необходимости — исходный документ или эталон.
- Формат вывода. Схема ответа: поля с оценкой, обоснованием, при необходимости — список нарушений.
Рубрика — самая важная и самая хрупкая часть. Плохая рубрика («оцени качество от 1 до 5») даёт оценки, которые невозможно ни воспроизвести, ни защитить. Рабочая рубрика состоит из проверяемых признаков: фактов, которые можно сверить с источником; пунктов вопроса, на которые дан ответ; формата, который требуется соблюсти. Критерий «ответ понравился» проверяемым не является — две модели-судьи разойдутся на нём почти случайно.
Полезны few-shot примеры: 2–4 ответа с выставленными баллами и коротким объяснением, почему именно такой балл. Они калибруют шкалу: без примеров судья по-своему трактует, чем «3» отличается от «4».
Порядок работы обычно такой: собрать набор тестовых вопросов и эталонных ответов, написать рубрику, прогнать судью, сверить его оценки с оценками человека на 30–50 примерах, и только потом доверять ему массовые прогоны.
Виды оценки
| Вид | Что подаётся судье | Что на выходе | Когда применять |
|---|---|---|---|
| Pairwise | вопрос и два ответа (A и B) | какой лучше или ничья | сравнение двух версий промпта или модели |
| Pointwise по рубрике | вопрос и один ответ | балл, например 1–5 или 1–10 | мониторинг качества на потоке |
| Reference-based | вопрос, ответ и эталон | балл с опорой на эталон | есть проверенные ответы человека |
| Classification-судья | вопрос и ответ |
pass / fail плюс причина |
проверка требований: формат, наличие ссылок, запрещённые формулировки |
Pairwise — самый надёжный режим, когда речь о выборе между вариантами: судье проще сравнить два ответа, чем поставить абсолютный балл. Его слабое место — позиционная предвзятость (о ней ниже).
Pointwise даёт абсолютную шкалу и позволяет строить графики качества во времени, но баллы разных прогонов сравнимы только при неизменной рубрике.
Reference-based ближе всего к классическим метрикам, только сверка идёт по смыслу, а не по совпадению слов. С эталоном судья ошибается заметно реже: в той же работе MT-Bench доля пропущенных неверных ответов на математических задачах падала с 14 из 20 до 3 из 20, когда судье давали правильный ответ для сверки.
Classification-судья не оценивает качество, а проверяет соответствие правилу: есть ли в ответе ссылка на источник, не выдуман ли номер заказа, соблюдена ли длина. Это дешёвая проверка, которую можно ставить в CI на каждый коммит.
Как писать рубрику
Рубрика превращает субъективное «хорошо» в список того, что можно проверить. Четыре правила, которые снимают большую часть проблем:
- Критерии отдельно, шкала отдельно. Для RAG-ответа критерии обычно такие: опора на найденные фрагменты (нет утверждений, которых в источниках не было), полнота (все части вопроса закрыты), отсутствие противоречий, соответствие тону. Шкала описывается для каждого критерия: что такое 1, 3 и 5.
- Оценка по проверяемым признакам. Вместо «насколько ответ полезен» — «указан ли срок возврата и совпадает ли он с документом». Судья справляется с проверкой наличия и совпадения гораздо лучше, чем с оценкой полезности.
-
Явный формат вывода. Схема с полями
score,violations,reason;reasonдолжен ссылаться на конкретное место в ответе, а не пересказывать его. - Запрет на рассуждения о себе. Если не ограничить, судья начинает писать «как языковая модель, я считаю» и оценивать стиль вместо содержания.
Для критериев, которые можно выразить правилом, судью лучше не использовать вовсе: длину ответа, наличие обязательного поля и корректность JSON проверяет код.
Смещения и как их гасить
Судья — это модель, и у неё есть устойчивые перекосы. Они описаны в литературе и воспроизводятся на практике.
Position bias. В pairwise-режиме судья склонен выбирать ответ, стоящий первым. В MT-Bench у одного из судей при прямой формулировке промпта согласованность при перестановке ответов местами составляла 23.8%, а первый вариант он предпочитал в 75% случаев. Лечится просто: каждый пример прогоняется дважды с переставленными ответами, и если вердикты расходятся — ставится ничья. Это удваивает стоимость, но убирает основной источник ошибки.
Verbosity bias. Длинный ответ кажется лучше короткого. В той же работе авторы проверили это атакой «повторяющийся список»: к ответам добавили бессмысленно раздутые пункты, и судьи стали выбирать раздутые варианты: доля таких ошибок составила 91.3% у Claude-v1 и GPT-3.5 и 8.7% у GPT-4. Гасится прямым указанием в рубрике («длина не является критерием; неполный ответ не может получить высший балл») и проверкой пар «короткий точный / длинный размытый».
Self-preference (self-enhancement bias). Судья завышает оценки ответам, написанным той же моделью или тем же семейством. Авторы G-Eval отдельно отмечают, что LLM-оценщики склонны предпочитать тексты, сгенерированные LLM. Отсюда правило — судить чужой моделью: ответы Claude оценивать GPT, ответы GPT — Claude. Если это невозможно, хотя бы не использовать того же провайдера.
Sycophancy и подстройка под промпт. Судья соглашается с намёком в задании: вопрос «этот ответ хороший?» подталкивает к согласию. Формулировка должна быть нейтральной и симметричной для обоих вариантов, а вопросы — закрытыми и без оценки в тексте.
Ограниченная способность рассуждать. Судья ошибается там, где нужен многошаговый вывод. В MT-Bench на математических задачах GPT-4 в роли судьи пропустил 14 неверных ответов из 20 при стандартном промпте; chain-of-thought снизил это до 6 из 20, а сверка с эталоном — до 3 из 20.
Что помогает в сумме: отдельная модель-судья, перестановка в pairwise, несколько независимых прогонов с голосованием, калибровка на человеческих оценках и периодическая ручная проверка выборки. Ни один из этих приёмов не устраняет смещение полностью — они снижают его до уровня, на котором метрика становится полезной для сравнения версий.
Когда судья врёт
Судья даёт правдоподобные, но неверные оценки в предсказуемых ситуациях:
- Длинные ответы. Много воды, мало фактов — оценка высокая. Проверять: рубрика с явным запретом и тестовые пары, где короткий ответ лучше длинного.
- Код без запуска тестов. Судья не выполняет код и не видит, что программа падает; синтаксически аккуратный, но нерабочий ответ получает балл. Для кода единственный надёжный судья — тесты.
- Фактология без источников. Если судье не дали документ, он оценивает правдоподобие, а не истинность. Уверенно сформулированная галлюцинация проходит проверку.
-
Задачи со строгим ответом. Числа, даты, единицы измерения: здесь
exact matchточнее и в разы дешевле любой модели.
Общее правило: судья хорош там, где критерий можно объяснить словами и сверить с материалом, и плох там, где нужен внешний исполнитель — компилятор, тест, база данных.
Связь с RouterAI
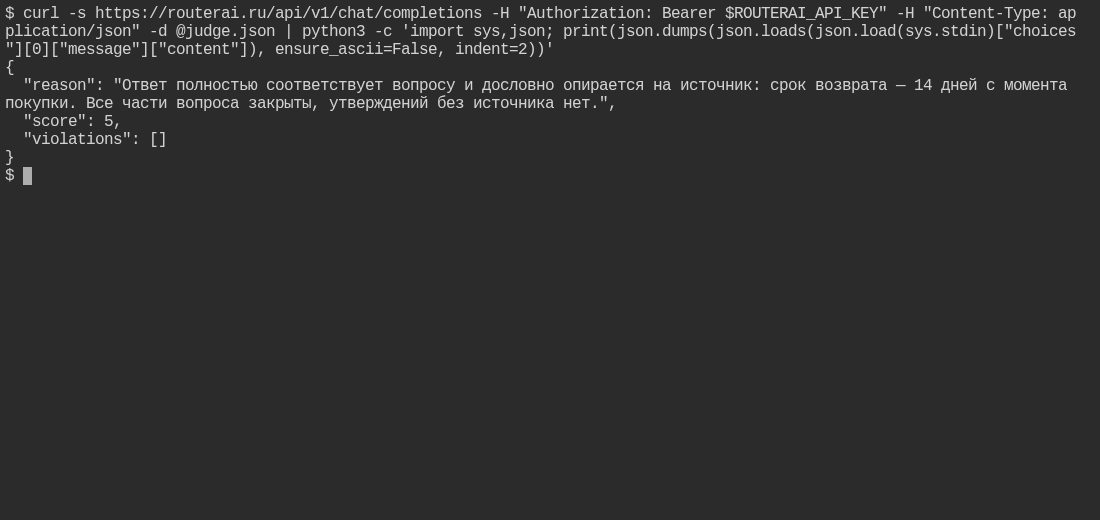
Через RouterAI судья собирается из обычного вызова чата: OpenAI-совместимый API https://routerai.ru/api/v1, ключ sk-xxxxxxxxxxxxxxxx, любая модель из общего каталога в роли судьи. Оплата в рублях, работа из России без VPN.
import json

from openai import OpenAI

client = OpenAI(
    base_url="https://routerai.ru/api/v1",
    api_key="sk-xxxxxxxxxxxxxxxx",
)

JUDGE_SCHEMA = {
    "type": "json_schema",
    "json_schema": {
        "name": "verdict",
        "strict": True,
        "schema": {
            "type": "object",
            "properties": {
                "score": {"type": "integer"},
                "violations": {"type": "array", "items": {"type": "string"}},
                "reason": {"type": "string"},
            },
            "required": ["score", "violations", "reason"],
            "additionalProperties": False,
        },
    },
}

RUBRIC = """Оцени ответ по шкале 1-5. Критерии:
5 - все части вопроса закрыты, каждое утверждение опирается на источник;
3 - ответ верен, но неполон;
1 - есть утверждения, которых нет в источнике, или вопрос не раскрыт.
Длина ответа не является критерием."""

def judge(question: str, answer: str, source: str) -> dict:
    resp = client.chat.completions.create(
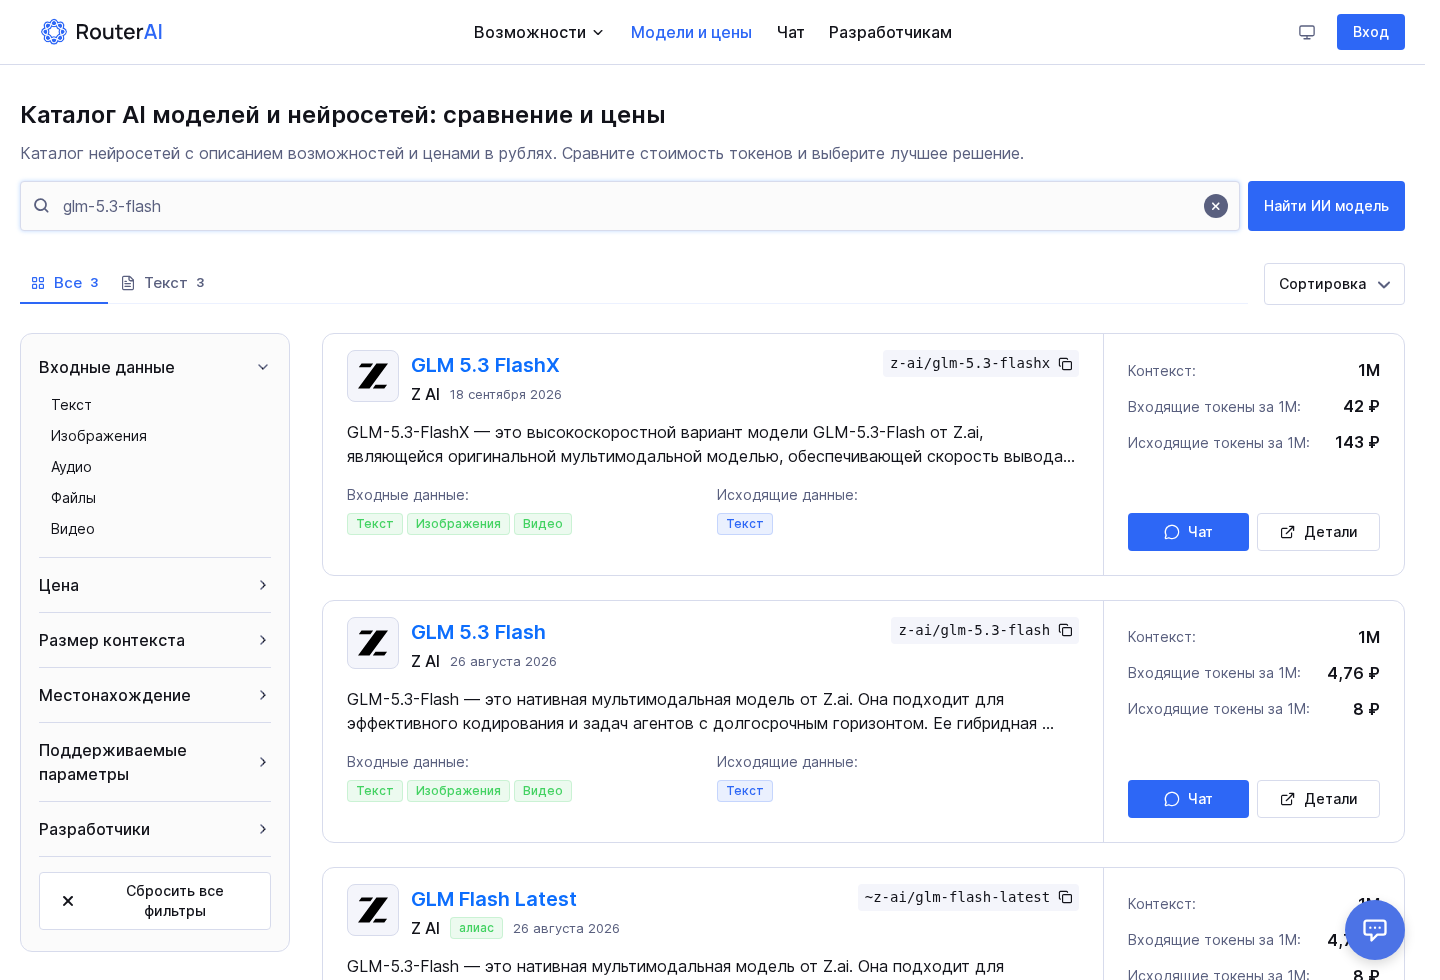
        model="z-ai/glm-5.3-flash",
        response_format=JUDGE_SCHEMA,
        messages=[
            {"role": "system", "content": RUBRIC},
            {"role": "user", "content": f"Вопрос: {question}\n\nИсточник: {source}\n\nОтвет: {answer}"},
        ],
    )
    return json.loads(resp.choices[0].message.content)
Роли моделей удобно разделить по цене и сложности задачи:
| Роль | Модель из каталога | Почему |
|---|---|---|
| Массовые проверки по рубрике | z-ai/glm-5.3-flash |
одна из самых дешёвых текстовых моделей, справляется с проверкой признаков |
| Классификация pass/fail, простые правила | deepseek/deepseek-v4.1-flash-1017 |
низкая цена, контекст около миллиона токенов |
| Судья по умолчанию для спорных кейсов | anthropic/claude-haiku-5.5 |
заметно дешевле флагманов (цены — в каталоге) |
| Арбитраж сложных и пограничных случаев |
anthropic/claude-sonnet-5.5 или openai/gpt-5.5
|
используется только для выборки, которую дешёвая модель не решила |
Схема «дешёвый судья на всё, дорогой — на спорное» экономит основную часть бюджета: доля пограничных случаев зависит от задачи и рубрики. Стоимость одного прогона зависит от модели, длины ответа и рубрики — актуальные цены смотрите в каталоге.
Два технических приёма, которые заметно снижают расходы:
-
Структурированный вывод. В RouterAI поддерживается
response_formatс типомjson_schema: модель возвращает объект строго по схеме, разбирать текст регулярками не нужно. Подробнее — Structured Output. -
Кэширование промптов. Если рубрика и few-shot примеры длинные, они повторяются в каждом запросе. Через Anthropic Messages API
https://routerai.ru/apiблок промпта помечаетсяcache_control, и повторяющаяся часть читается из кэша — в ответе это видно в поляхcache_creation_input_tokensиcache_read_input_tokens. Как это устроено — в статье Кэширование промптов.
Сравнение с другими способами оценки
| Способ | Что измеряет | Сильная сторона | Слабая сторона |
|---|---|---|---|
| Exact match | точное совпадение с эталоном | бесплатно, воспроизводимо | ломается от любой переформулировки |
| BLEU / ROUGE | совпадение n-грамм | быстро, не требует модели | слабо коррелирует с оценкой человека на творческих и разнообразных задачах |
| Embedding similarity | близость смысла | дешевле судьи, не зависит от промпта | не проверяет факты и логику |
| LLM-as-a-Judge | соответствие рубрике | работает там, где нет эталона | стоит денег, подвержен смещениям |
| Ручная разметка | всё, что заметит человек | эталон качества | дорого и медленно |
Практическая схема — комбинировать: код проверяет формат и запускает тесты, exact match закрывает задачи со строгим ответом, судья оценивает открытые ответы, а человек размечает выборку для калибровки. Подробнее о метриках — в статье Evaluation Metrics (LLM Eval).
Связанные термины
- Evaluation Metrics (LLM Eval) — общий обзор метрик, в который LLM-as-a-Judge входит как один из подходов
- Тестирование языковых моделей (LLM Evaluation) — процесс проверки моделей перед запуском
- Structured Output — как получить от судьи вердикт в виде JSON по схеме
- Кэширование промптов — как не платить за повторную рубрику в каждом запросе
- LLM Benchmarks — публичные тесты, которые решают похожую задачу сравнения моделей
- Расширенная генерация с поиском (RAG) — самый частый объект оценки судьёй
Что почитать
- Judging LLM-as-a-Judge with MT-Bench and Chatbot Arena, Zheng et al. — базовые виды смещений судьи, их измерение и способы смягчения
- G-Eval: NLG Evaluation using GPT-4 with Better Human Alignment, Liu et al. — оценка через chain-of-thought и пошаговое заполнение формы; Spearman-корреляция 0.514 с человеком на суммаризации
- Каталог моделей RouterAI — актуальные модели-судьи и их цены